01短剧后期美食视频AI 视频
场景音效与拟音
把分镜需求直接变成可进时间线的脚步、衣料、道具与环境声,适用于短剧、美食视频和 AI 视频后期。
制作需求
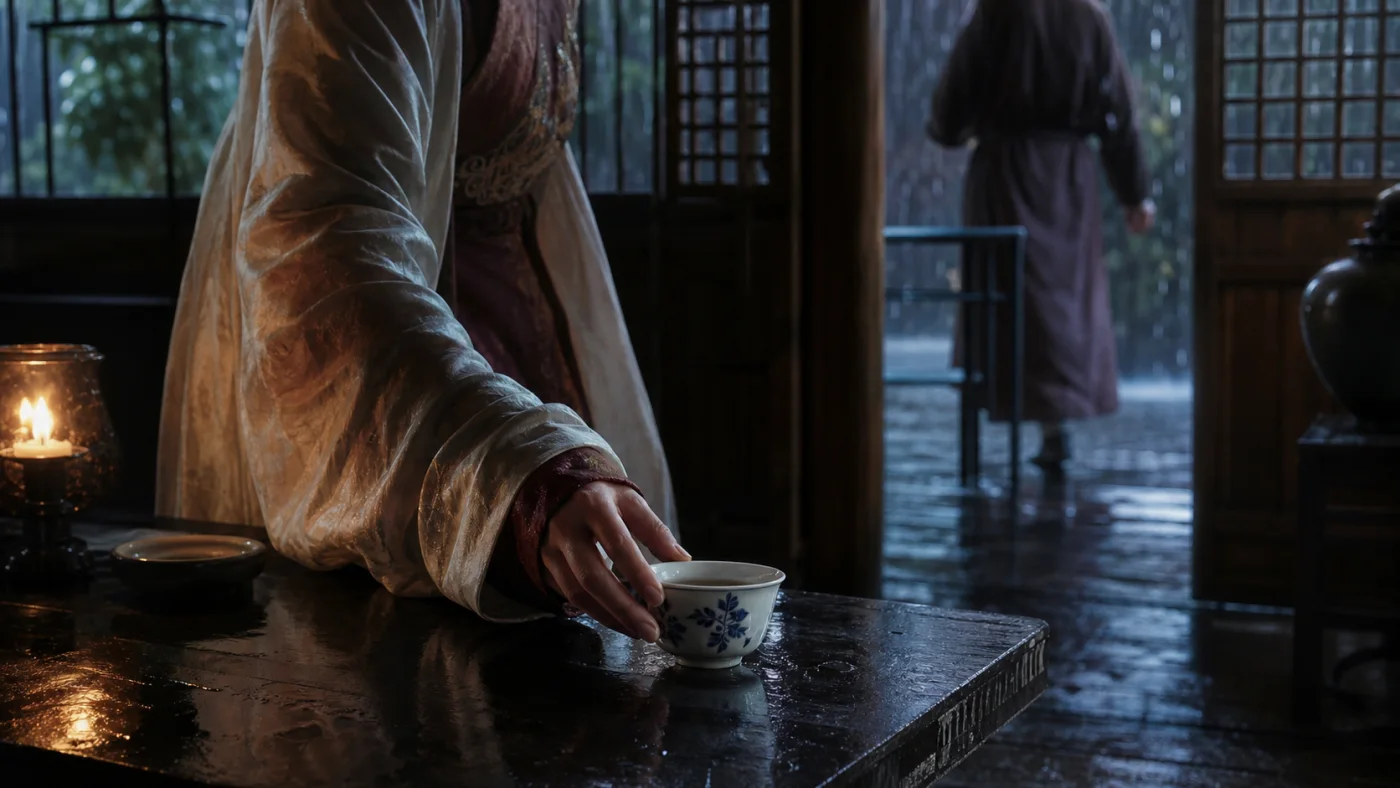
生成 12 秒纯拟音:雨夜木质茶馆,丝袖擦过桌面,三步皮靴靠近,木门滑开,最后瓷杯落在木桌上。不要对白和音乐。
生成音频
雨夜茶馆
0:120:00
Seed Audio 1.0 是字节 Seed 的一体化音频生成模型,面向完整声音场景创作。你可以用文本、图像或音频上下文引导多角色对白、情绪表达、原生口音、环境声、背景音乐与拟音音效。
Seed Audio 1.0
声音场景 Prompt 预览
Prompt 概念
两个角色在雨夜巷口低声交谈,底部有紧张弦乐,远处车流、脚步声,最后一声金属门撞击。
使用下方 Seed Audio 1.0 工作区,通过提示词、可选参考音频或一张参考图像生成声音场景。
输入
以提示词为核心,可选更多生成控制。
更多设置
展开后可调整更多输入控制。
历史记录
你的 Seed Audio 1.0 Preview 最近生成记录。
登录后可查看生成历史。
模型概览
Seed Audio 1.0 是字节跳动 Seed 团队推出的多模态 AI 音频生成模型,可根据文本、图像和音频输入创建完整声音场景。它不只把文字转换成语音,还能在同一工作流中组合多角色对白、情绪化人声、自然口音、环境声、背景音乐和拟音音效。
提示词可以同时描述说话人、时间节点、情绪、语言、地点、音乐方向和声音事件,适合电影化场景、多语言对白、广告、播客、游戏,以及其他需要让人声与周围声景协同工作的项目。
深入了解 Seed Audio 1.0输入
文本、图像,以及最多 3 段参考音频
声音层
对白、人声、环境声、音乐与音效
输出
最长 2 分钟的完整声音场景
使用方法
在线使用 Seed Audio 1.0 时,先写清声音场景提示词,按需添加音频或图片参考,选择输出设置,然后在 SeedAudio.co 工作区生成并检查音频结果。
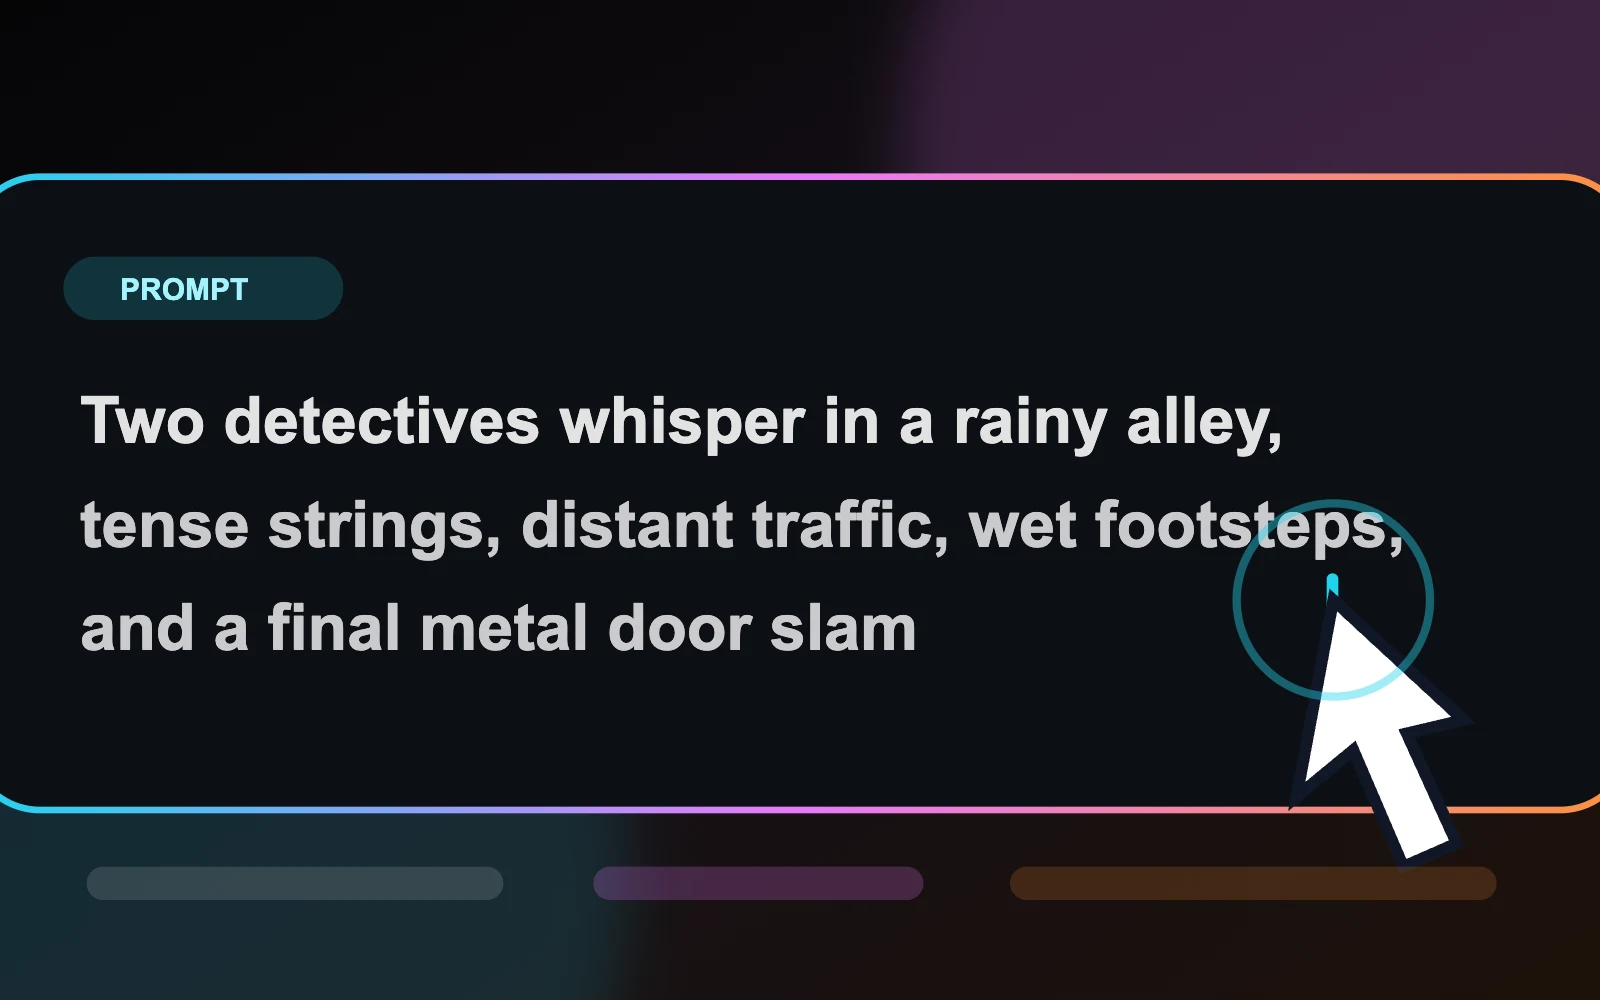
描述角色、语言、情绪、地点、对白、环境声、音乐方向,以及你希望出现的声音事件。
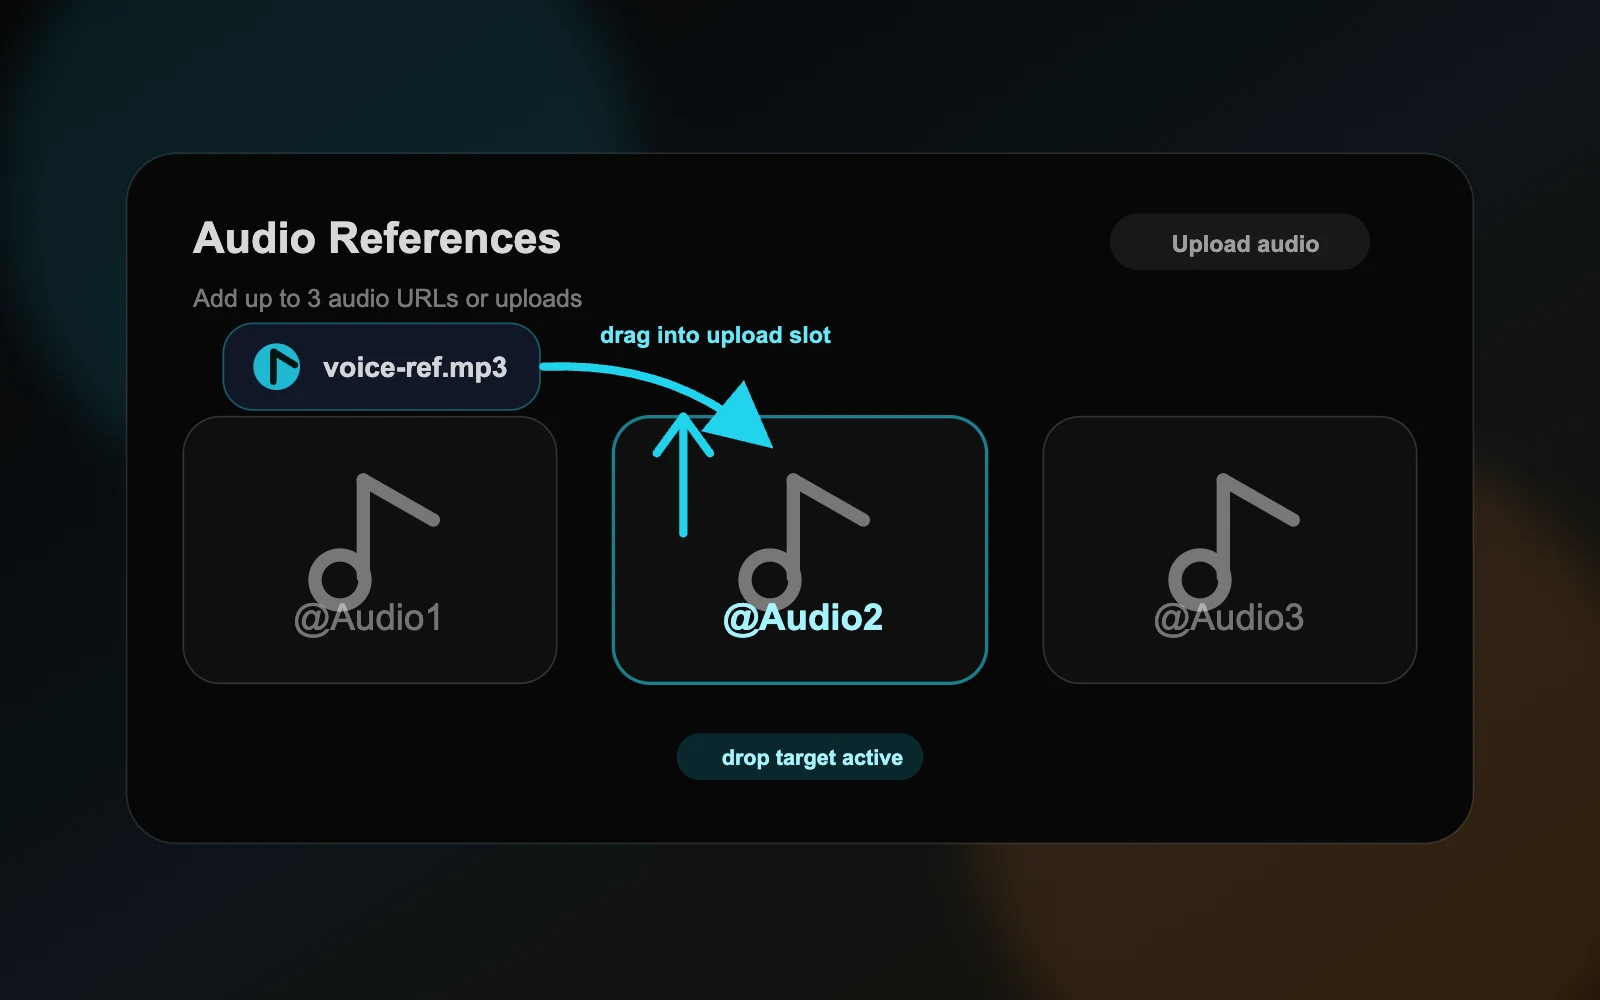
可以用最多 3 段音频参考来引导声音或风格,也可以用 1 张图片参考来引导情绪和场景上下文。
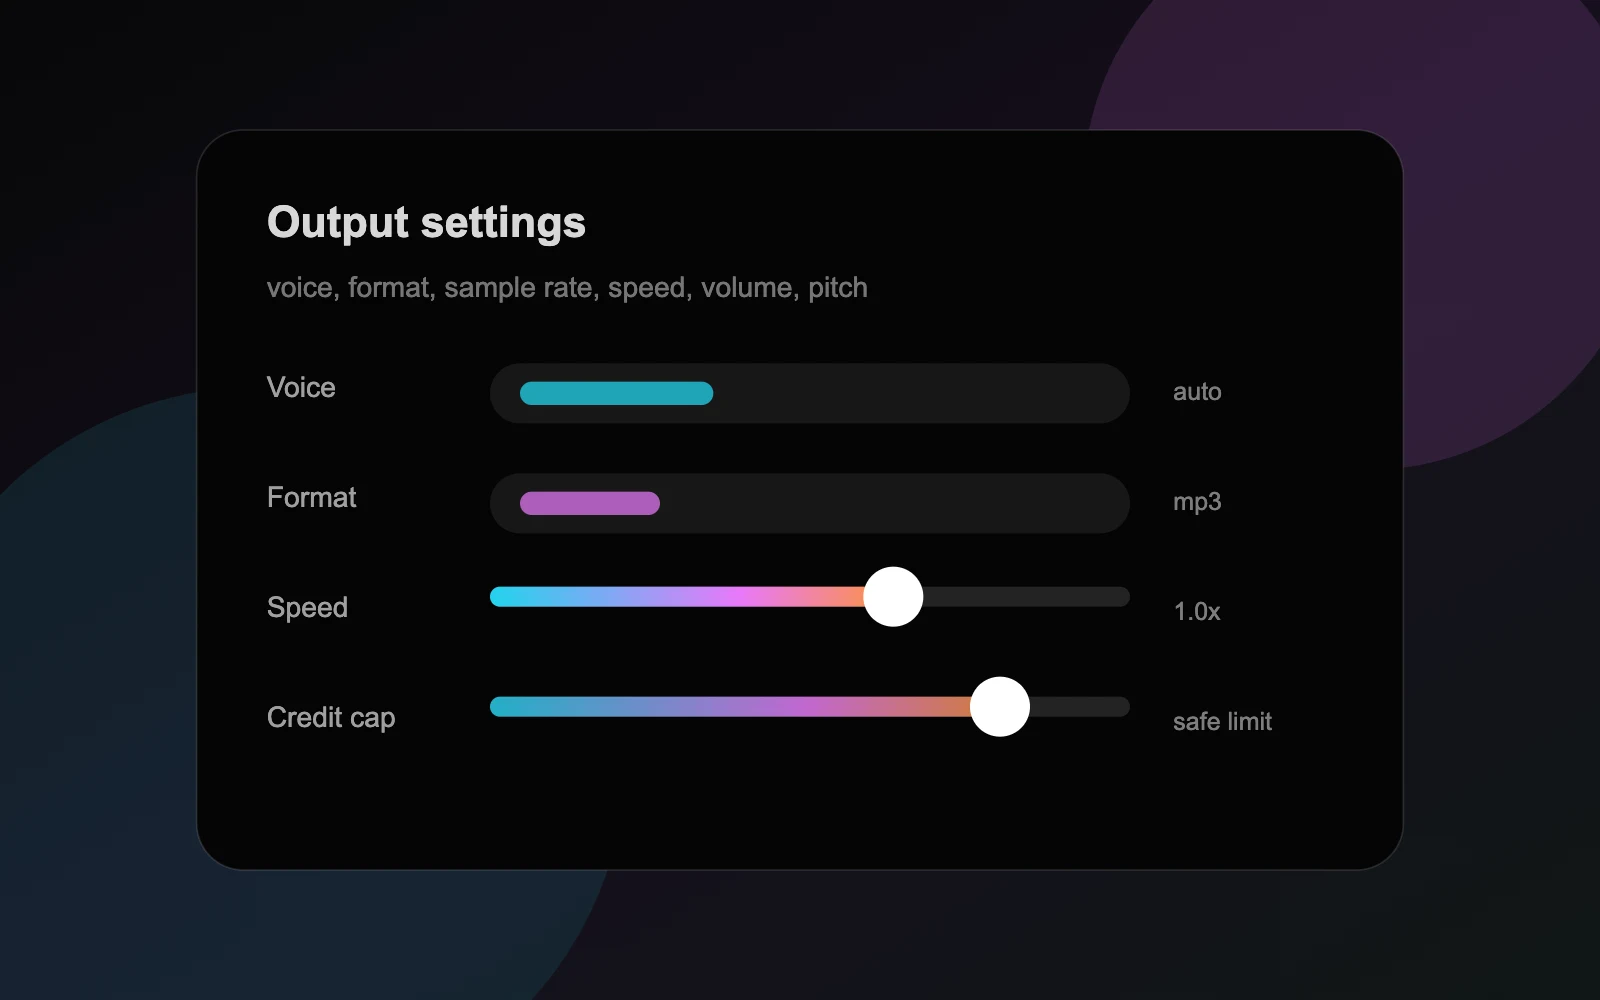
生成前选择声音、输出格式、采样率、速度、音量、音高和最大积分上限。
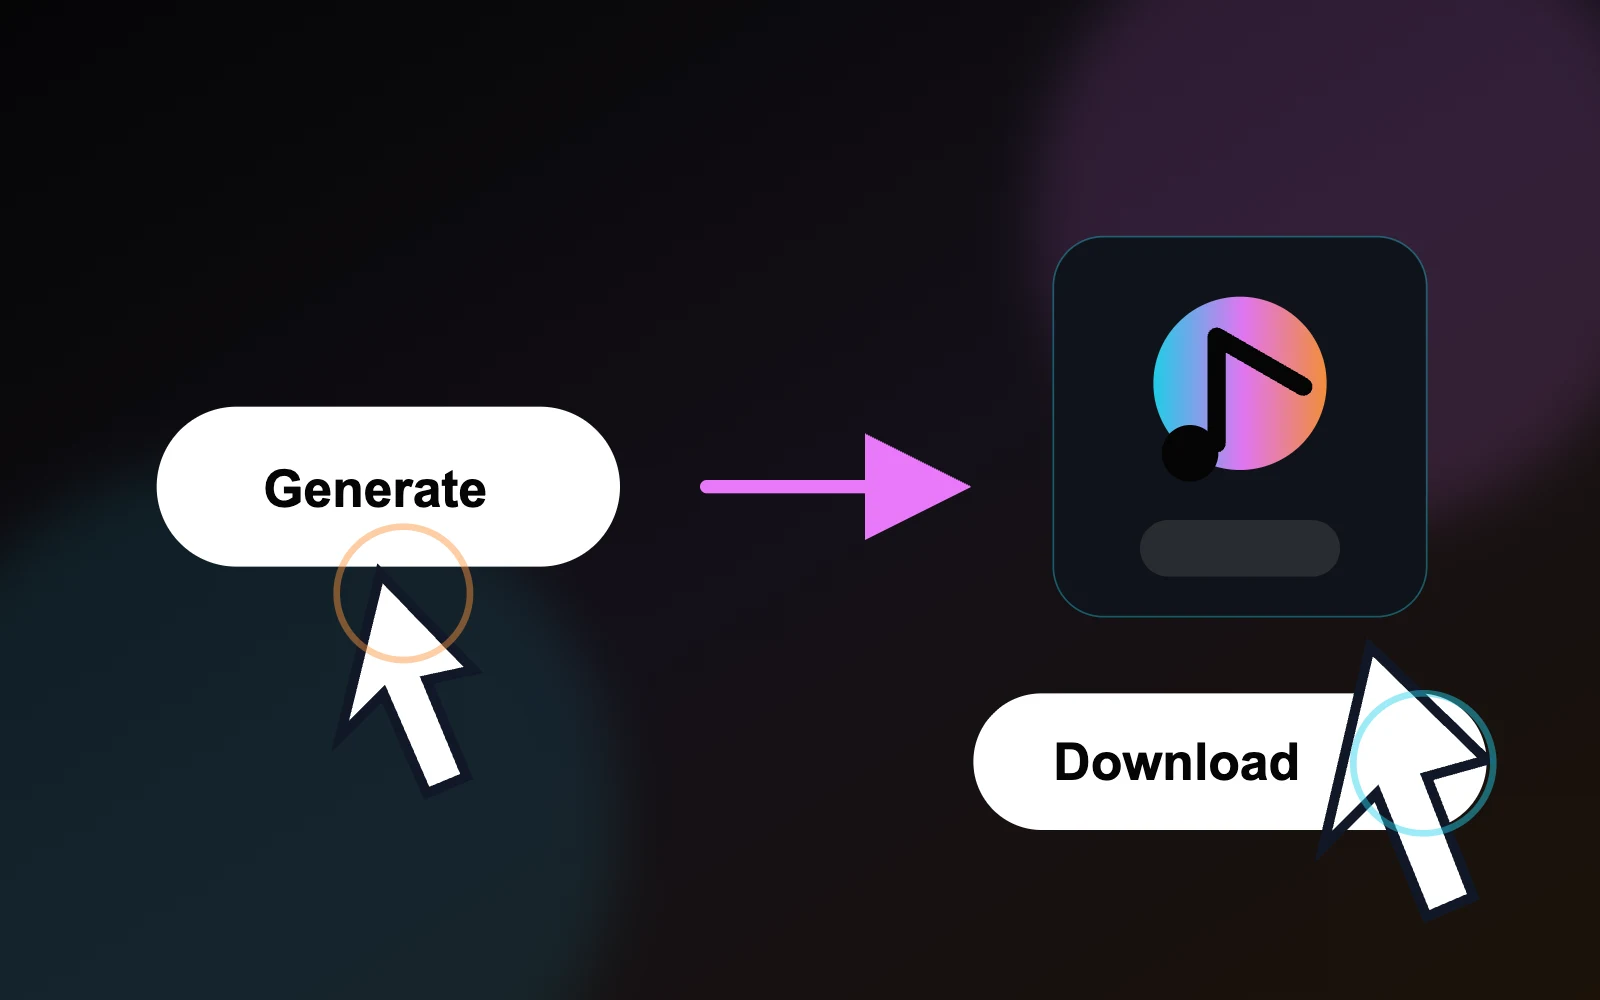
先生成一段短草稿,检查人声清晰度和各声音层的平衡,再复制、下载或继续修改结果。
提示词公式
场景 + 说话人 + 情绪 + 语言 + 环境声 + BGM + 音效 + 时间节点。
面向真实内容生产
从一段制作需求出发,生成精确卡点的拟音、原创音乐、多语言对白与可复用的授权声线。
把分镜需求直接变成可进时间线的脚步、衣料、道具与环境声,适用于短剧、美食视频和 AI 视频后期。
生成 12 秒纯拟音:雨夜木质茶馆,丝袖擦过桌面,三步皮靴靠近,木门滑开,最后瓷杯落在木桌上。不要对白和音乐。
雨夜茶馆
0:12
为影视、广告和地域化内容生成原创配乐、记忆点与背景音乐,不必再花时间翻找曲库素材。
创作一段丝路夜行电影配乐:弹拨乐器、框鼓与现代低音结合,在第 8 秒进入清晰记忆点。纯器乐,不要人声。
丝路夜行
0:16
用明确的角色、情绪和母语级表达完成对白、广告与旁白本地化,而不是机械的单声线朗读。
黎明前的港口,将同一段克制的双人对白分别生成意大利语和中文版本。保持自然发音、轻微港口环境声,不要音乐。
港口灯光 · 意大利语
0:14
让已获授权的角色声线或品牌声音在不同剧集、广告和市场中保持一致,同时按需更换文案。
使用 @Audio1 作为已授权的声音参考,保留温暖的音色、从容语速和轻柔口音,朗读:‘Every new chapter begins with one clear breath.’
授权原声
静谧时刻 · 原声
0:09生成版本
新的篇章 · 克隆
0:07Seed Audio 1.0 与传统 TTS 对比
传统 TTS 的核心任务是把文字转换成语音;Seed Audio 1.0 面向更完整的音频生成工作流,可在一个声音场景中统筹对白表演、环境声、音乐和音效。
| 对比维度 | Seed Audio 1.0 | 传统 TTS(如早期商业 TTS、基础语音合成) |
|---|---|---|
| 核心定位 | 全场景音频创作(Scene-level Audio Creation) | 纯文本转语音(Text-to-Speech) |
| 生成内容 | 人声对白 + 背景音乐 + 音效 + 环境声(一次生成并混音) | 仅人声(单一语音轨道) |
| 多角色对白 | 原生支持,单次生成多角色、情绪、节奏协调的对话 | 需多次调用不同音色,再人工对齐/混音 |
| 背景音乐 & 音效 | 支持,与对白同步生成,自动匹配情绪与时间线 | 不支持,需额外工具(音乐模型 + 音效库 + DAW) |
| 输入方式 | 文本提示词 / 参考音频(最多 3 段)/ 参考图片 | 主要是文本 + 预设音色(部分支持简单参考) |
| 语音克隆 | 零样本(Zero-shot),上传短参考音频即可(约 30 秒内) | 多数需要微调/训练,或依赖有限音色库 |
| 情绪与表现力控制 | 自然语言提示词直接描述情绪、语气、口音、节奏 | 主要靠 SSML 标签或有限参数,控制范围较窄 |
| 时间轴控制 | 支持精细时间戳控制对白出现时机 | 基本无此能力 |
| 输出形式 | 完整混好的音轨(非流式,最长约 2 分钟/次) | 单一语音文件,需后期拼接音乐与音效 |
| 适用场景 | 有声剧、短剧配音、广告、游戏音频、播客冷开场、视频旁白等需要完整声音场景的内容 | 有声书朗读、导航、客服、简单旁白等纯语音需求 |
| 工作流变化 | 一条提示词 → 成品音轨(大幅减少后期混音) | 语音生成 → 找音乐 → 找音效 → 手动对齐混音 |
如果只需要稳定、可预测的语音,传统 TTS 依然更简单;如果环境与声音设计也是成品的一部分,Seed Audio 1.0 更合适。
清晰流程
从声音想法出发,用一条 Prompt 定义角色、情绪、地点、对白、音乐、环境与音效,形成完整的声音场景方向。
从角色、情绪、地点、节奏、对白、音乐氛围和需要出现的音效开始。
Seed Audio 1.0 面向对白、情绪语气、原生口音、环境声、BGM 与独立音效的一体化合成。
为短片、广告、播客、游戏、学习内容等需要快速验证完整声景的项目提供声音方向。
Seed Audio 1.0 技术方向
Seed Audio 1.0 面向完整音频场景:多角色对白、情绪、语气、口音、环境底声、BGM 和拟音可以在一次创作流程中完成。
多说话人
长声音场景中的音色连续性
文本 / 图像 / 音频
面向音频创作的多模态提示
不再把人声、音乐、环境和音效拆到多个工具里拼接,而是在一次生成里编排多层声音。
引导语气、情绪表达、方言和原生口音,同时让反复出现的声音在不同语境中保持可识别。
在对白旁同步生成环境底声、背景音乐、房间声、天气、人群或远处城市质感。
Seed Audio 1.0 面向更长的声音场景,适合对白、环境声和带音乐的片段化内容生成。
创作可能性
当项目需要的不只是旁白,而是有角色、情绪、空间和事件的完整声景时,Seed Audio 1.0 的价值最明显。
为分镜或预演草拟对白、情绪点、拟音、环境和音乐。
为产品演示、社媒短片和本地化广告快速生成声音方向。
在最终音频制作前,原型化环境循环、角色语音、UI 声和过场声效。
用空间声音线索构建情景课程、角色对话和沉浸式讲解。
带情绪语气的多角色表达
雨声、车流、房间、人群与自然底声
脚步、撞击、开门、质感与时机
价格
按需购买一次性积分包,适合测试、个人创作和更高用量的 AI 音频生成。所有付费订阅和积分包均包含 Seed Audio 1.0 API 调用权限,网页版与 API 共用同一积分余额。
查看 Seed Audio 1.0 完整价格无需订阅,小额积分包适合先试用。
适合偶尔做内容项目的灵活积分包。
适合不订阅但需要较高用量的一次性积分包。
常见问题
给想了解 Seed Audio 1.0 并用于 AI 音频生成的创作者提供实用答案。