Seed Audio 1.0
S'inscrire
Générateur audio IA Seed Audio 1.0

Générateur audio IA Seed Audio 1.0

Seed Audio 1.0 est le modèle de génération audio tout-en-un de ByteDance Seed. Utilisez du texte, une image ou un contexte audio pour guider les dialogues multi-intervenants, l'expression émotionnelle, les accents, l'ambiance, la musique et les effets Foley.

2 min
fenêtre de génération audio par session
Un seul prompt
contrôle dialogue, ton, ambiance, BGM et SFX
Multimodal
contexte texte, image et audio pour les scènes sonores

Seed Audio 1.0

Aperçu du prompt de scène

Génération audio
Salle de contrôle abstraite de génération audio IA avec panneaux de formes d'onde

Concept du prompt

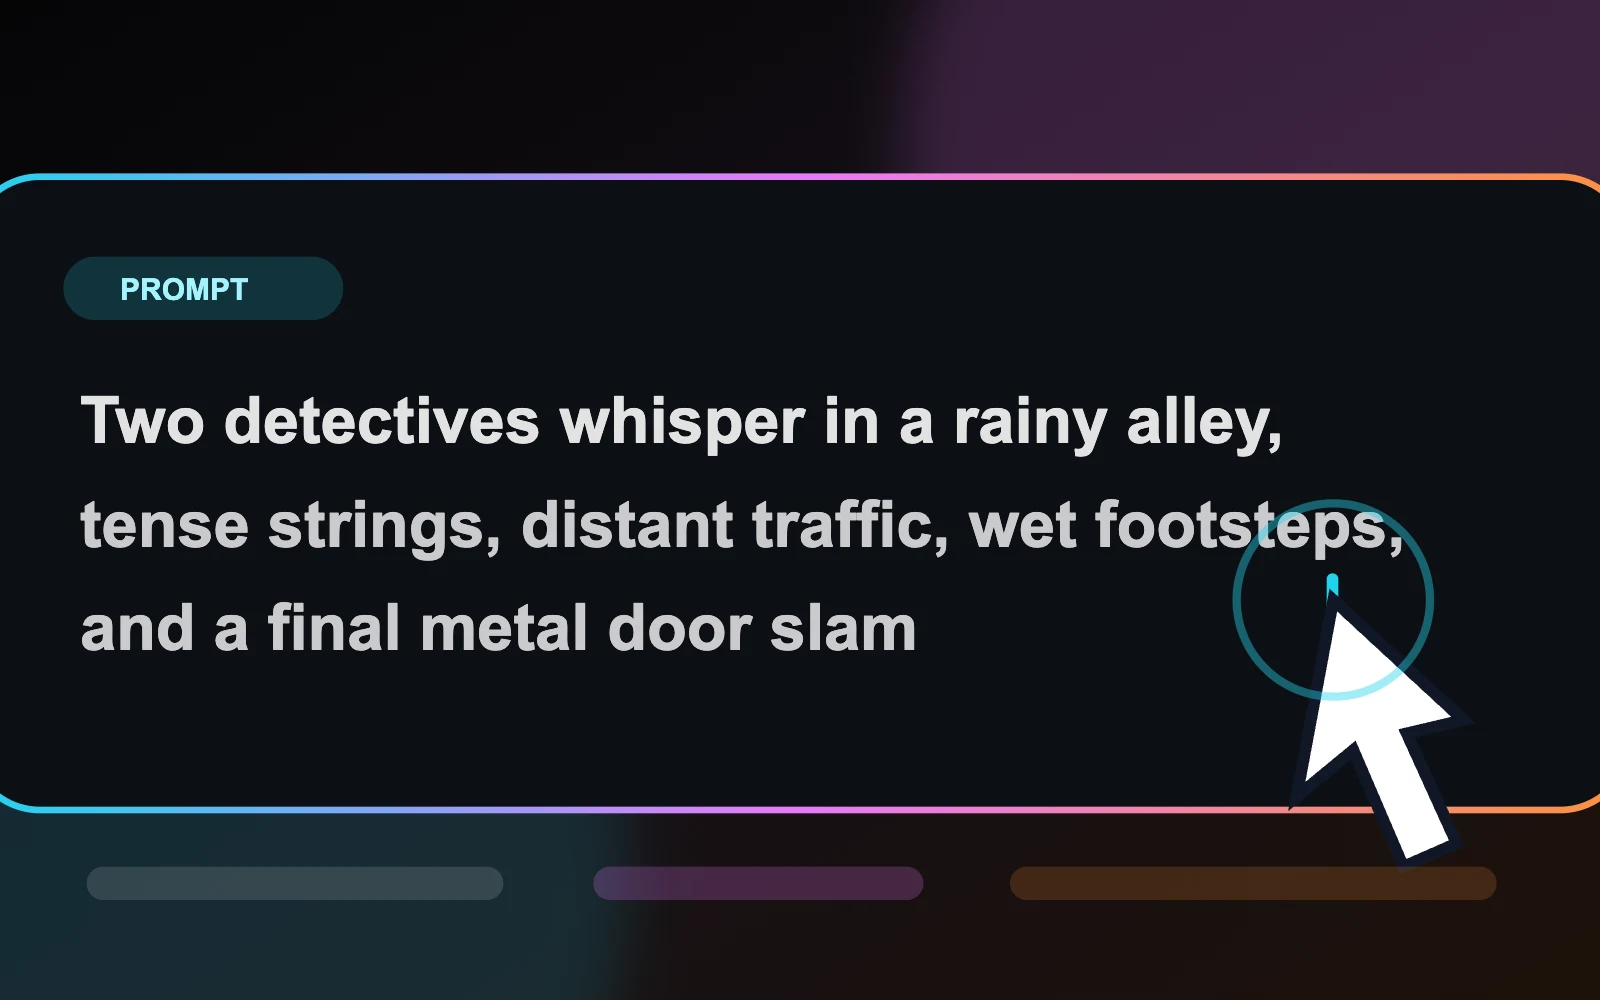
Deux voix chuchotent dans une ruelle sous la pluie, cordes tendues en fond, circulation lointaine, pas, et une porte métallique qui claque.

Pistes de dialogue
Nappe BGM
Ambiance + SFX

Commencez à générer Seed Audio 1.0 en ligne.

Utilisez l'espace de travail ci-dessous pour créer des scènes sonores à partir d'un prompt, d'un fichier audio ou d'une image de référence.

Entrée

Génération audio par prompt avec contrôles optionnels.

Prompt*
83/2048

Paramètres supplémentaires

Personnalisez votre entrée avec plus de contrôle.

Historique

Vos générations Seed Audio 1.0 Preview récentes.

Connectez-vous pour voir votre historique de générations.

Aperçu du modèle

Qu'est-ce que Seed Audio 1.0 ?

Seed Audio 1.0 est le modèle multimodal de génération audio par IA de ByteDance Seed, conçu pour créer des scènes sonores complètes à partir de texte, d'images et d'audio. Dans un même flux, il peut réunir dialogues à plusieurs voix, interprétations expressives, accents naturels, ambiance, musique de fond et effets sonores de type bruitage, au lieu de produire uniquement de la parole.

Les prompts peuvent décrire ensemble les intervenants, le timing, l'émotion, la langue, le lieu, la direction musicale et les événements sonores. Le modèle convient aux scènes cinématographiques, dialogues localisés, publicités, podcasts, jeux et projets où la voix et le paysage sonore doivent rester cohérents.

En savoir plus sur Seed Audio 1.0

Entrées

Texte, image et jusqu'à 3 références audio

Couches sonores

Dialogue, voix, ambiance, musique et effets

Sortie

Une scène audio coordonnée jusqu'à 2 minutes

Mode d'emploi

Comment utiliser Seed Audio 1.0 en ligne.

Pour utiliser Seed Audio 1.0 en ligne, rédigez un prompt de scène sonore, ajoutez éventuellement une référence audio ou image, choisissez les réglages de sortie, puis générez et vérifiez l'audio dans l'espace de travail SeedAudio.co.

  1. Éditeur de prompt Seed Audio 1.0 pour rédiger un prompt structuré de scène sonore
    01

    Rédiger un prompt de scène sonore

    Décrivez les personnages, la langue, l'émotion, le lieu, le dialogue, l'ambiance, la direction musicale et les événements sonores voulus.

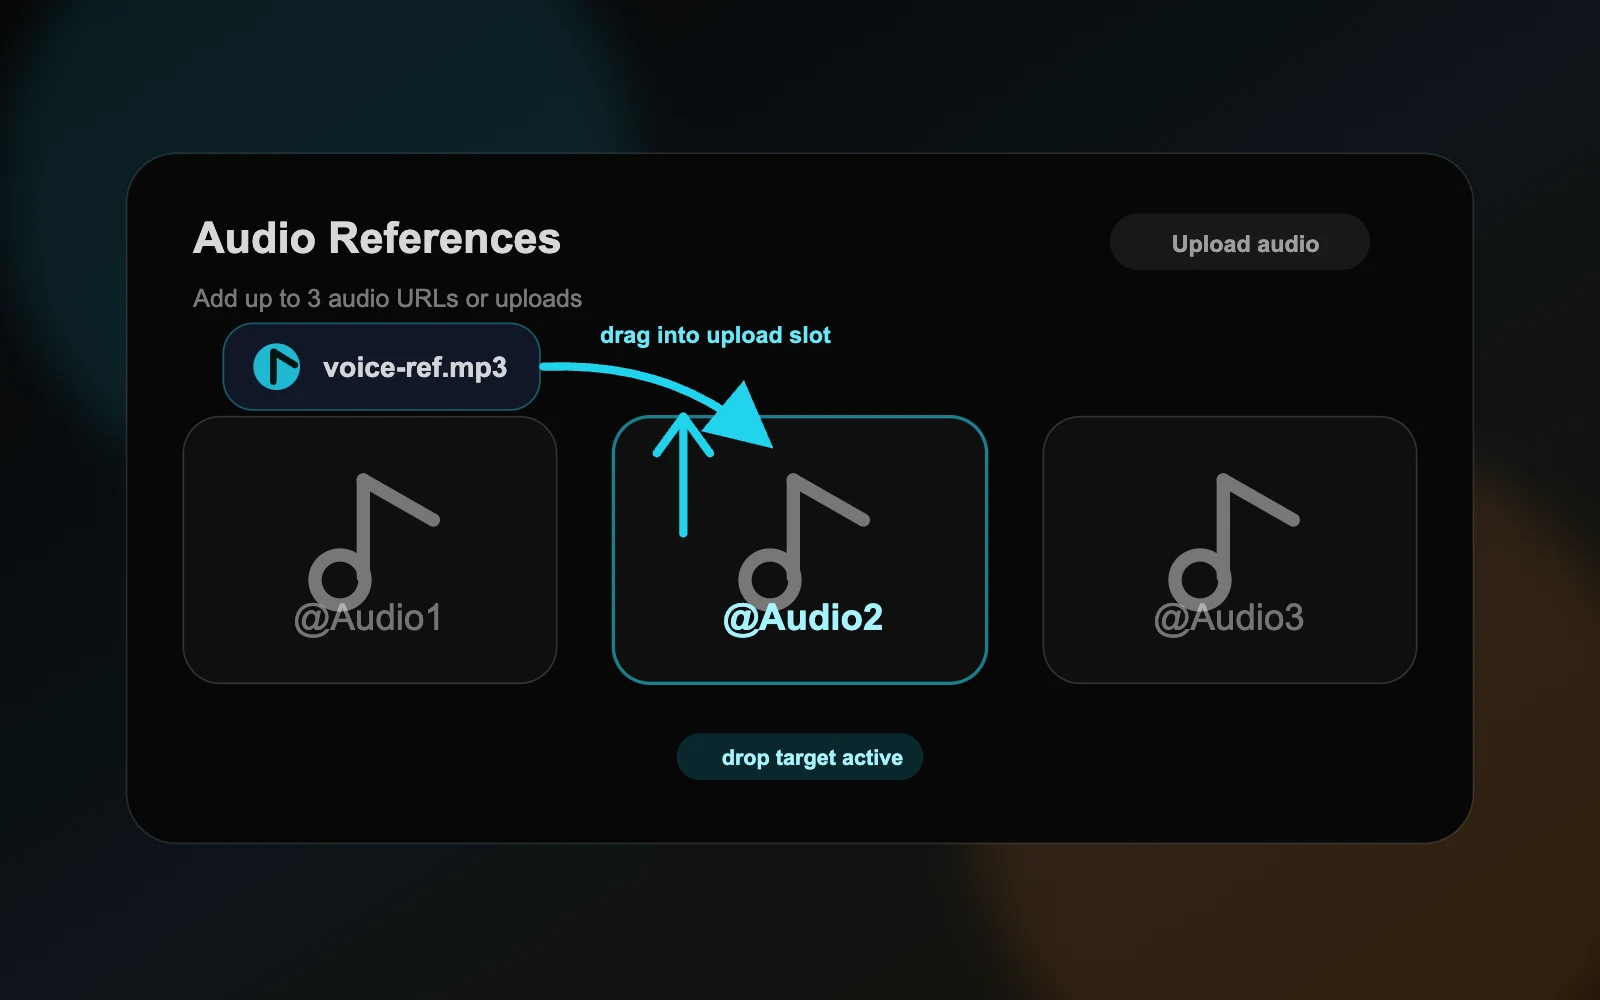
  2. Contrôles Seed Audio 1.0 pour ajouter des références audio ou une référence image
    02

    Ajouter des références facultatives

    Utilisez jusqu'à trois références audio pour orienter la voix ou le style, ou une image pour guider l'ambiance et le contexte de la scène.

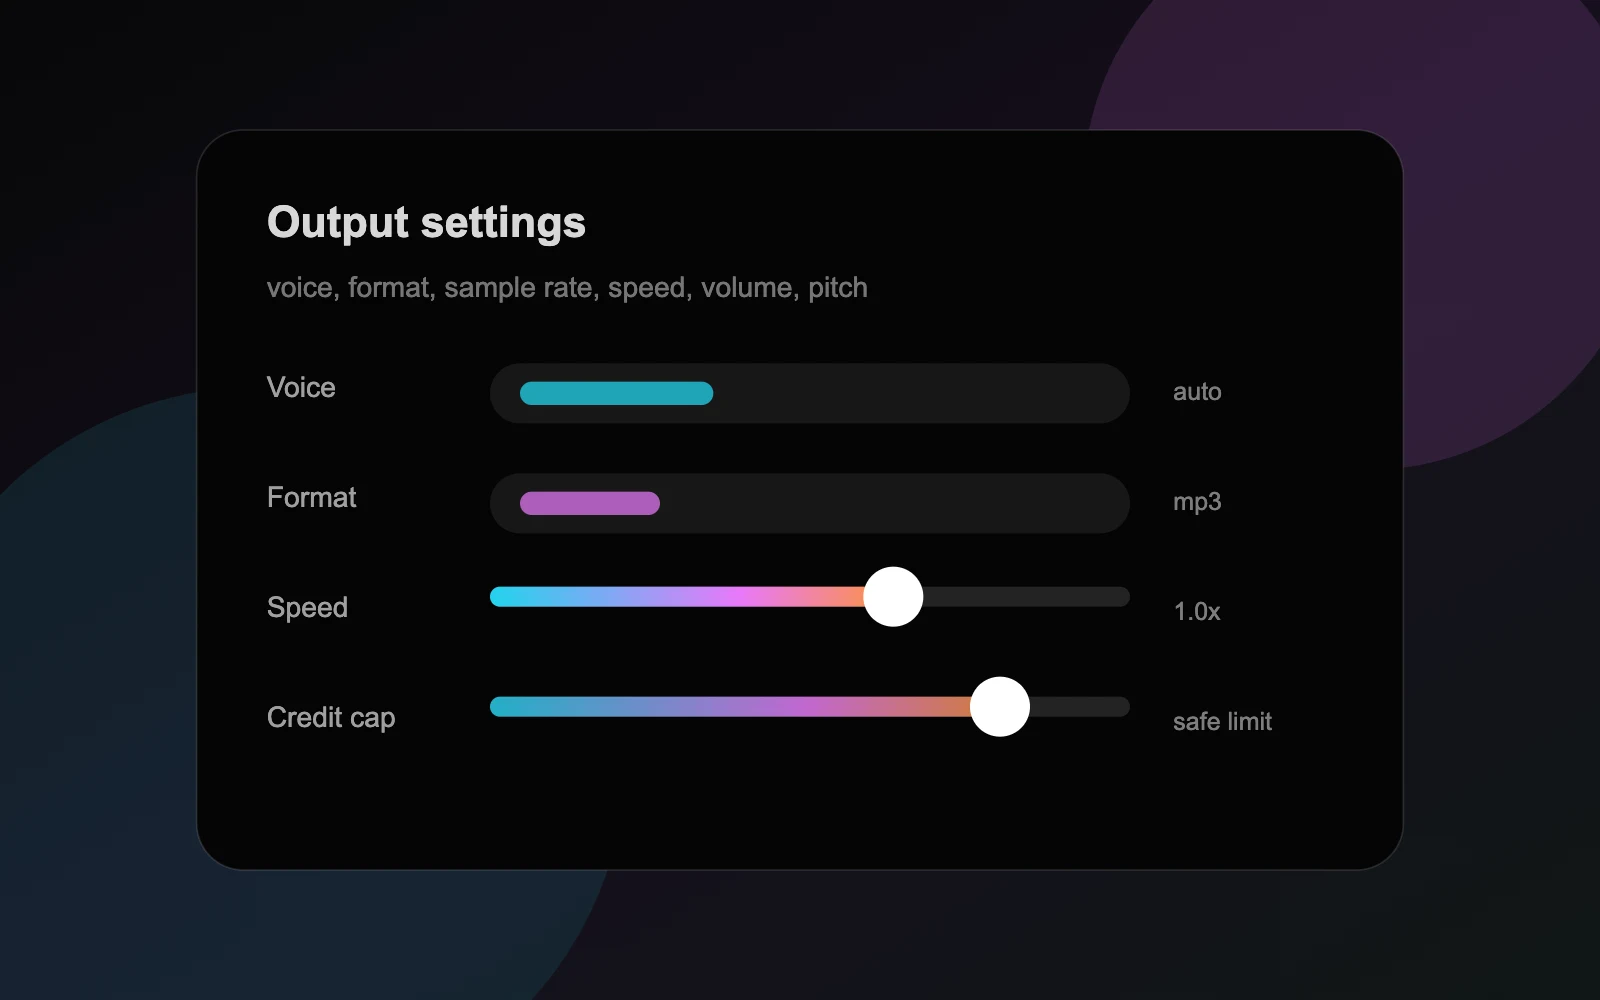
  3. Réglages de sortie Seed Audio 1.0 pour la voix, le format, la vitesse, le volume, la hauteur et le plafond de crédits
    03

    Choisir les réglages de sortie

    Sélectionnez la voix, le format, la fréquence d'échantillonnage, la vitesse, le volume, la hauteur et le plafond de crédits avant de générer.

  4. Résultat audio Seed Audio 1.0 généré avec lecture, copie de lien, téléchargement et régénération
    04

    Générer et vérifier

    Lancez d'abord un court brouillon, écoutez la clarté de la voix et l'équilibre des couches, puis copiez, téléchargez ou révisez le résultat.

Formule de prompt

Scène + locuteur + émotion + langue + ambiance + BGM + effets sonores + timing.

Pensé pour les workflows de production réels

Que pouvez-vous créer avec Seed Audio 1.0 ?

À partir d’un seul brief, créez des bruitages parfaitement synchronisés, de la musique originale, des dialogues multilingues et des voix autorisées réutilisables.

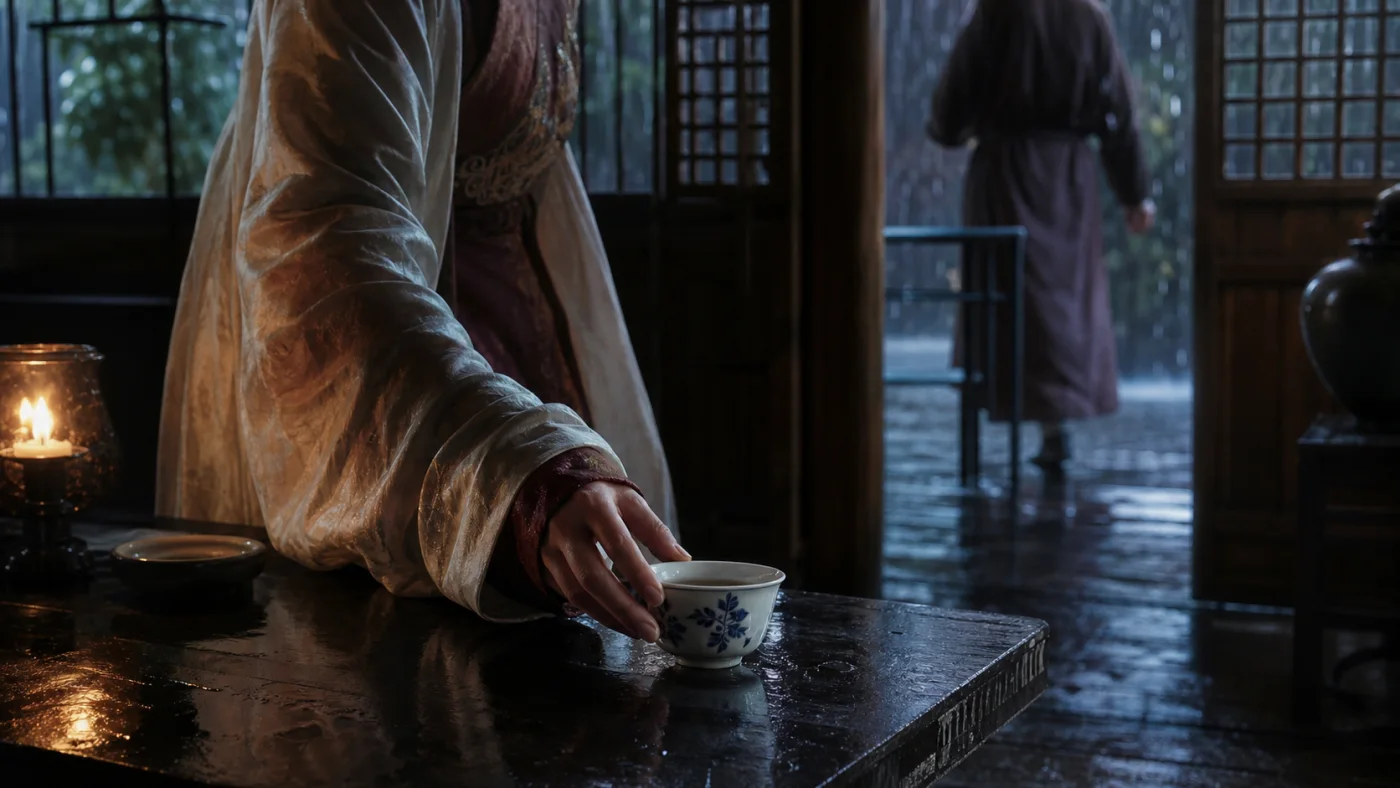
Une tasse en porcelaine dans une maison de thé ancienne sous la pluie
01Série courteVidéo culinairePostproduction IA

Son de scène et bruitage

Transformez un découpage en pas, froissements de tissu, accessoires et ambiances prêts au montage pour les séries courtes, les vidéos culinaires et la postproduction vidéo IA.

Brief de production

Créez 12 secondes de bruitage pur dans une maison de thé en bois sous la pluie : une manche de soie frôle la table, trois pas de chaussures en cuir approchent, une porte coulisse, puis une tasse en porcelaine se pose sur le bois. Sans dialogue ni musique.

Audio généré

Pluie sur la maison de thé

0:12
0:00
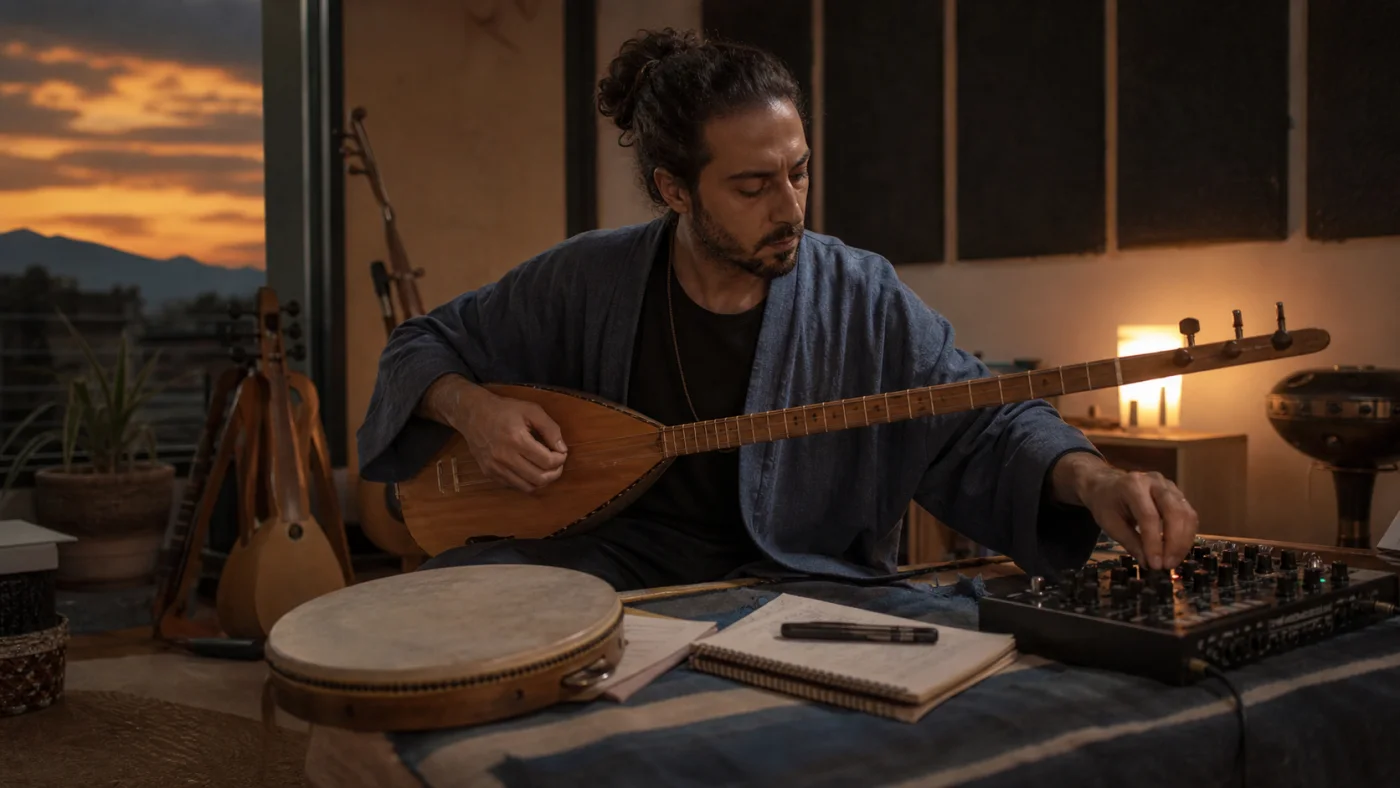
Un compositeur créant un morceau instrumental inspiré de la Route de la soie
02Bandes-sonMusique publicitaireStyles régionaux

Musique IA

Produisez des bandes-son, des accroches et des musiques d’ambiance originales pour les films, les publicités et les formats régionaux, sans parcourir des banques de sons.

Brief de production

Composez une musique cinématographique de trajet nocturne sur la Route de la soie, avec luth pincé, tambour sur cadre et basse moderne. Faites apparaître une accroche mémorable à la huitième seconde. Instrumental uniquement.

Audio généré

Route de la soie après la nuit

0:16
0:00
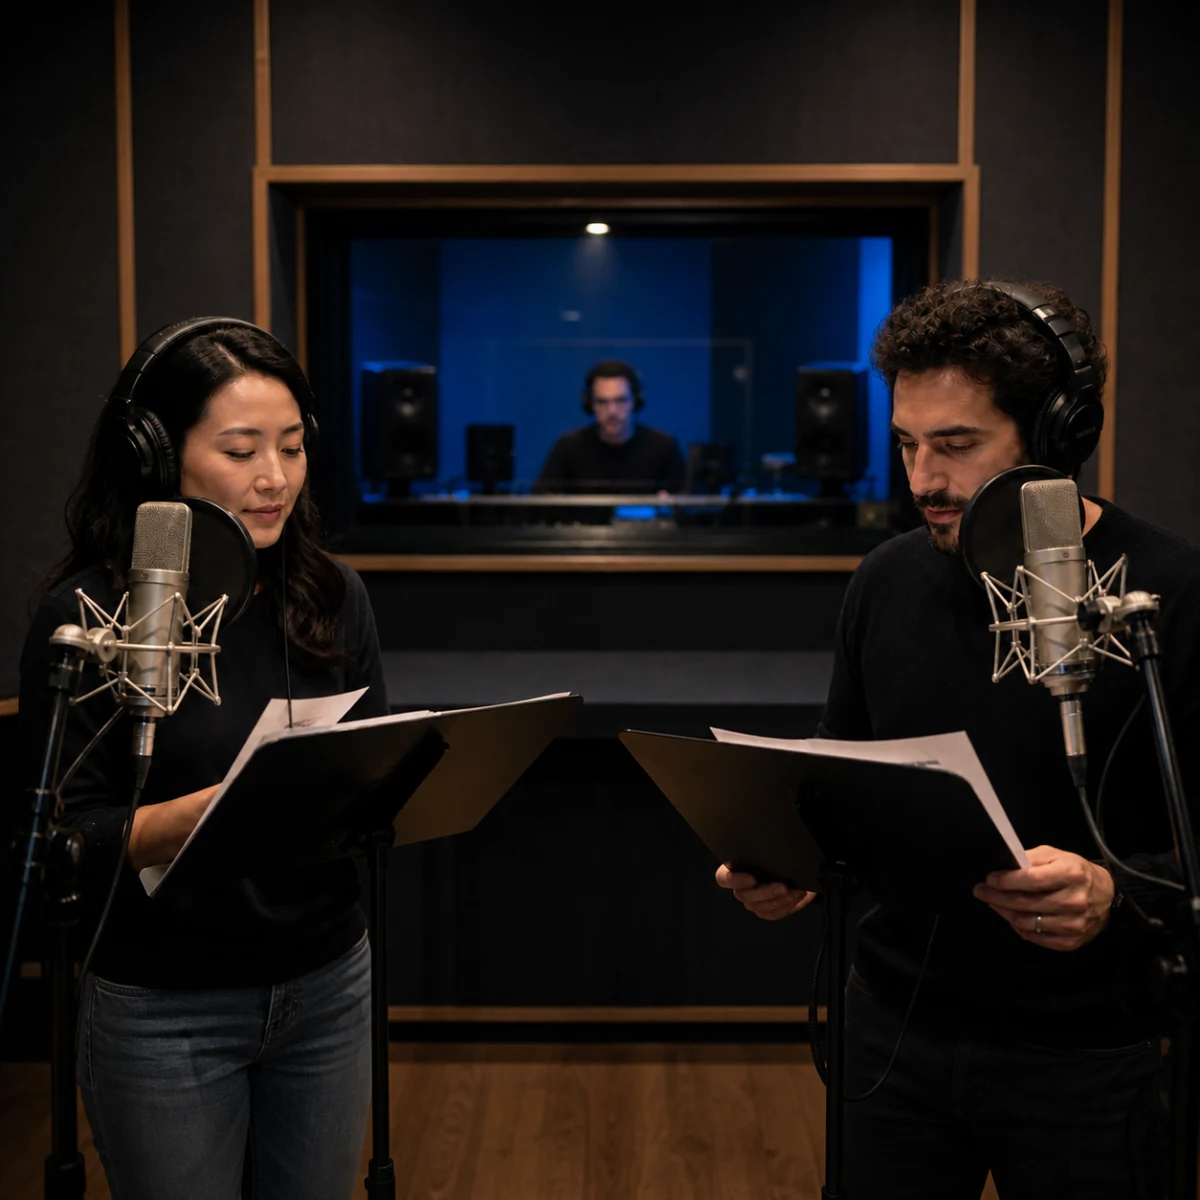
Deux comédiens enregistrant un dialogue multilingue dans un studio de doublage
03LocalisationDoublageVoix off commerciale

TTS et dialogue multilingue

Localisez dialogues, publicités et narrations avec des rôles distincts, des émotions maîtrisées et une diction naturelle, plutôt qu’une lecture monocorde.

Brief de production

Dans un port avant l’aube, créez le même échange retenu entre deux personnages en italien et en chinois. Conservez une prononciation naturelle, une légère ambiance portuaire et aucune musique.

Versions linguistiques

Lumière du port · Italien

0:14
0:00
Un narrateur autorisé enregistrant une bibliothèque vocale réutilisable
04Continuité du personnageVoix de marqueProduction en série

Clonage vocal

Conservez une voix de personnage ou de marque autorisée cohérente entre épisodes, campagnes et marchés, tout en changeant le script à la demande.

Brief de production

Utilisez @Audio1 comme référence vocale autorisée. Préservez son identité chaleureuse, son rythme mesuré et son léger accent en lisant : ‘Every new chapter begins with one clear breath.’

Comparaison des voix

Référence autorisée

Heure calme · Original

0:09
0:00

Variation générée

Nouveau chapitre · Cloné

0:07
0:00
Clonez uniquement les voix qui vous appartiennent ou pour lesquelles vous avez une autorisation explicite.

Seed Audio 1.0 vs traditional TTS

How Seed Audio 1.0 differs from traditional text-to-speech

Traditional TTS is designed to turn written text into spoken voice. Seed Audio 1.0 is designed for broader audio generation, combining dialogue, performance direction, ambience, music, and sound effects in one sound-scene workflow.

Feature comparison between Seed Audio 1.0 and traditional text-to-speech systems
CapabilitySeed Audio 1.0Traditional TTS (early commercial TTS and basic speech synthesis)
Core positioningScene-level audio creationText-to-speech
Generated contentSpoken dialogue + background music + sound effects + ambience, generated and mixed in one passVoice only (a single speech track)
Multiple speakersNative support for generating coordinated multi-character dialogue, emotion, and pacing in one passUsually requires repeated calls with different voices, followed by manual alignment and mixing
Background music & sound effectsGenerated with the dialogue and automatically matched to its emotion and timelineNot included; requires separate music models, sound libraries, and a DAW
Input methodText prompt / reference audio (up to 3 clips) / reference imageMainly text + a preset voice; some systems support basic references
Voice cloningZero-shot cloning from a short uploaded reference clip (about 30 seconds or less)Often requires fine-tuning or training, or relies on a limited voice library
Emotion & expressiveness controlDescribe emotion, tone, accent, and pacing directly in natural languagePrimarily controlled through SSML tags or limited parameters, with a narrower expressive range
Timeline controlFine timestamp control over when dialogue appearsGenerally not available
Output formatA fully mixed, non-streaming audio track up to about 2 minutes per generationA single voice file that requires music and sound effects to be added later
Best suited forAudio drama, short-form dubbing, ads, game audio, podcast cold opens, video narration, and other complete sound scenesAudiobook reading, navigation, customer service, simple narration, and other voice-only needs
Workflow changeOne prompt → finished audio track, substantially reducing post-production mixingGenerate speech → find music → find sound effects → align and mix manually

Traditional TTS remains the simpler choice when you only need predictable speech. Choose Seed Audio 1.0 when the surrounding scene and sound design are part of the output.

Workflow simple

De l'idée de scène à la conception sonore multicouche.

Passez d'une idée sonore à une direction de scène complète : personnages, émotion, lieu, dialogue, musique, ambiance et effets en un seul prompt.

01

Décrivez la scène sonore

Commencez par les personnages, l'émotion, le lieu, le timing, le dialogue, l'ambiance musicale et les effets qui devraient exister dans la scène.

02

Laissez le modèle composer les couches

Seed Audio 1.0 est conçu pour synthétiser dialogues, ton émotionnel, accents, ambiance, BGM et effets sonores distincts.

03

Utilisez dans tous les formats créatifs

Façonnez des directions audio pour courts métrages, pubs, podcasts, jeux, contenus éducatifs et autres projets.

Technologie Seed Audio 1.0

Un modèle sonore qui dépasse la synthèse vocale ordinaire.

Seed Audio 1.0 est conçu pour les scènes audio complètes : dialogues multi-personnages, émotion, ton, accents, ambiances, BGM et Foley.

Multi-intervenant

continuité vocale pour les longues scènes générées

Texte / image / audio

prompt multimodal pour la création audio

Génération audio tout-en-un

Composez plusieurs couches sonores à la fois au lieu d'assembler voix, musique, ambiance et effets dans des outils séparés.

Contrôle de l'émotion et de l'accent

Guide du ton, de l'émotion, du dialecte et des accents naturels.

Ambiance de scène et BGM

Générez des ambiances, BGM, sons de pièce, météo, foules et textures urbaines avec le dialogue.

Scènes audio longues

Seed Audio 1.0 est conçu pour les scènes sonores longues, incluant dialogues, ambiances et séquences musicales.

Possibilités créatives

Scènes sonores pour la vidéo, les jeux, l'éducation et la publicité.

Seed Audio 1.0 est idéal quand un projet a besoin de plus que de la narration : une scène acoustique complète.

Conception sonore pour courts métrages

Esquissez dialogues, émotions, Foley, ambiance et musique pour storyboards ou prévisualisation.

Créations marketing

Créez des directions sonores prêtes pour les campagnes : démos produit, clips sociaux et pubs localisées.

Prototypes jeu et XR

Prototypez des boucles ambiantes, des bruitages, des sons UI et des moments cinématiques.

Contenu éducatif

Créez des leçons scénarisées, des conversations et des explications immersives avec des indices sonores spatiaux.

Dialogue

Voix multi-personnages avec ton émotionnel

Ambiance

Pluie, trafic, pièces, foules et ambiances naturelles

Foley

Pas, impacts, portes, texture et timing

Tarifs

Choisissez le forfait Seed Audio 1.0 adapté

Abonnez-vous pour la meilleure valeur ou achetez des crédits quand vous en avez besoin. Tous les forfaits incluent la génération par prompt avec références optionnelles.

Voir les tarifs détaillés de Seed Audio 1.0
Free
0 $US

Essayez Seed Audio 1.0 avec des crédits d'inscription. Idéal pour tester des prompts et de courtes scènes.

  • 10 crédits gratuits
  • Jusqu'à ~8 secondes par génération
  • Jusqu'à 2 min d'audio par génération
  • Accès API
  • Support prioritaire
Pro
Économisez 39,98 $US
16,66 $US19,99 $US/mo

Le meilleur choix annuel pour les créateurs avec des besoins audio réguliers.

  • 30 000 crédits par an
  • Jusqu'à ~400 minutes audio au total
  • Tout Free inclus
  • Plus d'espace pour les projets longs
  • Uploads de voix de référence
  • Support prioritaire
  • Max 2 min par génération
  • Seed Audio 1.0 API access — shared credits
Max
Économisez 99,98 $US
41,66 $US49,99 $US/mo

La meilleure valeur pour les équipes qui prévoient une génération audio intensive.

  • 90 000 crédits par an
  • Jusqu'à ~1 200 minutes audio au total
  • Tout ce qui est dans Pro
  • Meilleur rapport qualité-prix
  • Plus grand buffer annuel
  • Adapté aux équipes et agences
  • Max 2 min par génération
  • Seed Audio 1.0 API access — shared credits
Des questions sur la facturation, l'accès ou des besoins personnalisés ?contact@seedaudio.co

FAQ

Questions fréquentes

Réponses pratiques pour les créateurs qui souhaitent comprendre Seed Audio 1.0 et l'utiliser pour la génération audio IA.

Créez des scènes sonores plus riches avec Seed Audio 1.0.

Suivez les capacités du modèle, l'état d'accès et les cas d'usage pratiques pour la génération audio IA multimodale.