Seed Audio 1.0
Daftar
Generator audio AI Seed Audio 1.0

Generator audio AI Seed Audio 1.0

Seed Audio 1.0 adalah model generasi audio all-in-one dari ByteDance Seed. Gunakan teks, gambar, atau audio untuk memandu dialog multi-pembicara, emosi, aksen, ambiens, BGM, dan efek Foley.

2 menit
jendela generasi audio per sesi
Satu prompt
kontrol dialog, nada, ambiens, BGM, dan SFX
Multimodal
konteks teks, gambar, dan audio untuk adegan suara

Seed Audio 1.0

Pratinjau prompt adegan

Generasi audio
Ruang kontrol generasi audio AI abstrak dengan panel gelombang berlapis

Konsep prompt

Dua pembicara berbisik di gang hujan, senar tegang di bawahnya, lalu lintas jauh, langkah kaki, dan pintu logam tertutup.

Batang dialog
Lapisan BGM
Ambiens + SFX

Mulai hasilkan Seed Audio 1.0 secara online.

Gunakan ruang kerja Seed Audio 1.0 di bawah untuk membuat adegan suara dari prompt, audio referensi, atau gambar.

Input

Generasi audio berbasis prompt dengan kontrol opsional.

Prompt*
83/2048

Pengaturan Tambahan

Sesuaikan input Anda dengan kontrol lebih lanjut.

Riwayat

Generasi Seed Audio 1.0 Preview terbaru Anda.

Masuk untuk melihat riwayat generasi Anda.

Gambaran model

Apa itu Seed Audio 1.0?

Seed Audio 1.0 adalah model generasi audio AI multimodal dari ByteDance Seed untuk membangun adegan suara lengkap dari input teks, gambar, dan audio. Dalam satu alur kerja, model ini dapat menggabungkan dialog multi-pembicara, suara ekspresif, aksen alami, ambiens, musik latar, dan efek suara bergaya foley, bukan hanya menghasilkan ucapan.

Prompt dapat menjelaskan pembicara, waktu, emosi, bahasa, lokasi, arah musik, dan peristiwa suara sekaligus. Model ini cocok untuk adegan sinematik, dialog lokal, iklan, podcast, game, dan proyek lain yang membutuhkan suara serta lanskap audio bekerja sebagai satu kesatuan.

Pelajari Seed Audio 1.0 lebih lanjut

Input

Teks, gambar, dan hingga 3 referensi audio

Lapisan suara

Dialog, suara, ambiens, musik, dan efek

Output

Satu adegan audio terkoordinasi hingga 2 menit

Cara menggunakan

Cara menggunakan Seed Audio 1.0 online.

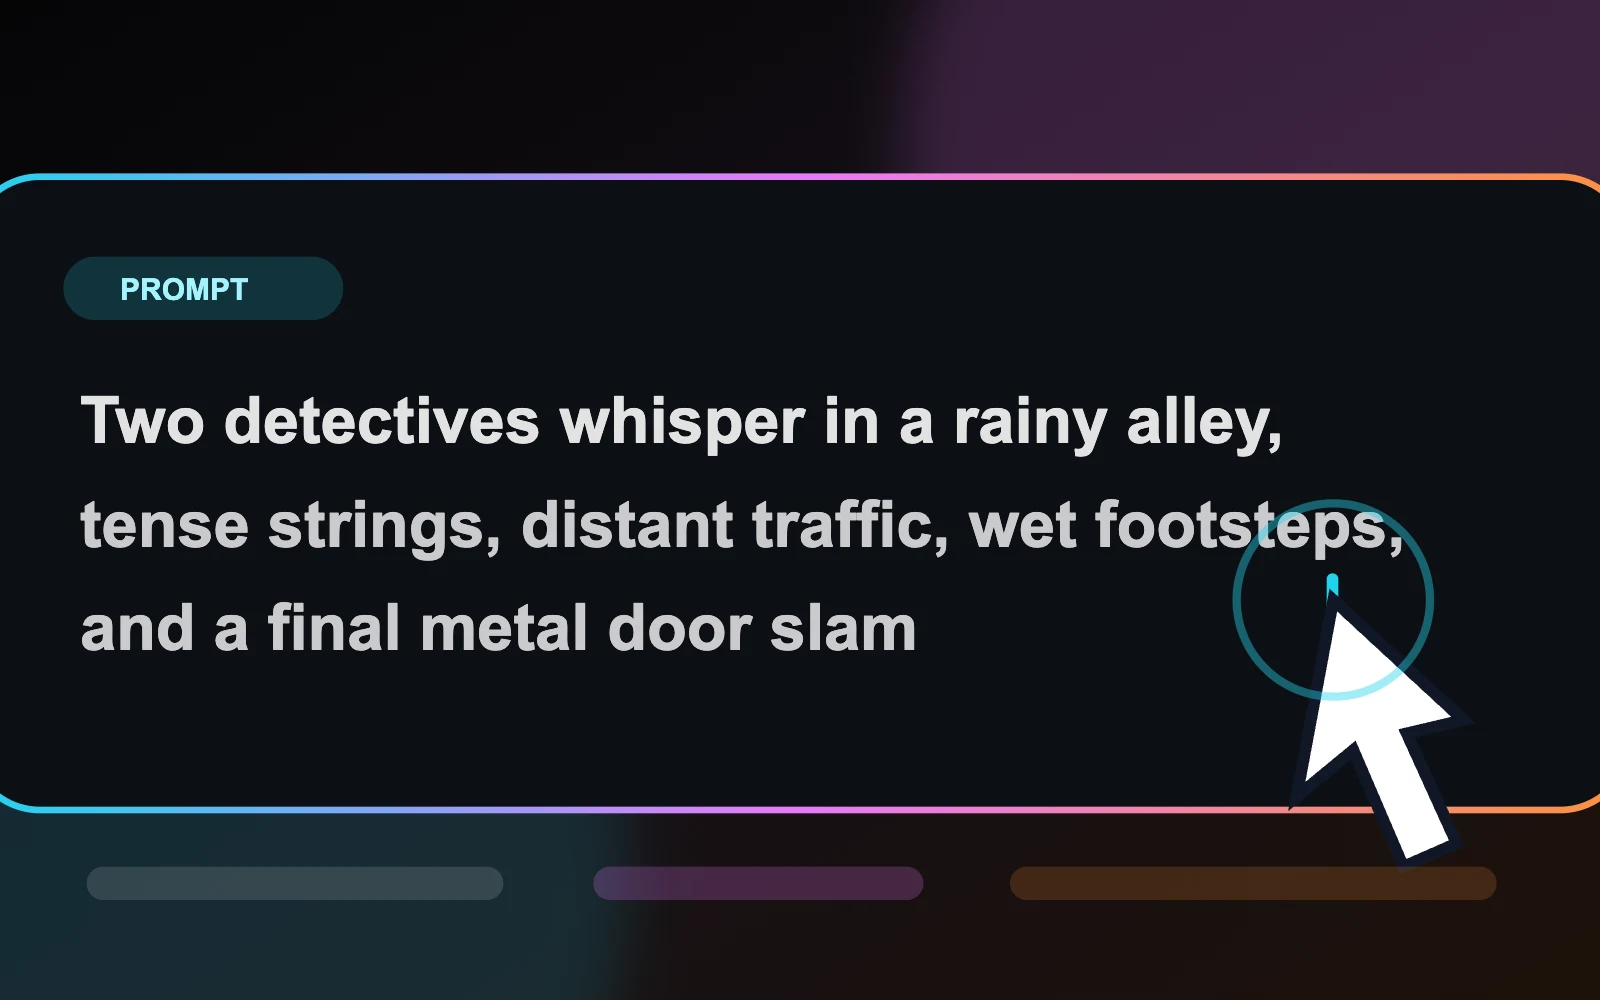
Untuk menggunakan Seed Audio 1.0 online, tulis prompt scene suara, tambahkan referensi audio atau gambar bila perlu, pilih pengaturan output, lalu generate dan tinjau audio di workspace SeedAudio.co.

  1. Editor prompt Seed Audio 1.0 untuk menulis prompt scene suara yang terstruktur
    01

    Tulis prompt scene suara

    Jelaskan karakter, bahasa, emosi, lokasi, dialog, ambiens, arah musik, dan peristiwa suara yang diinginkan.

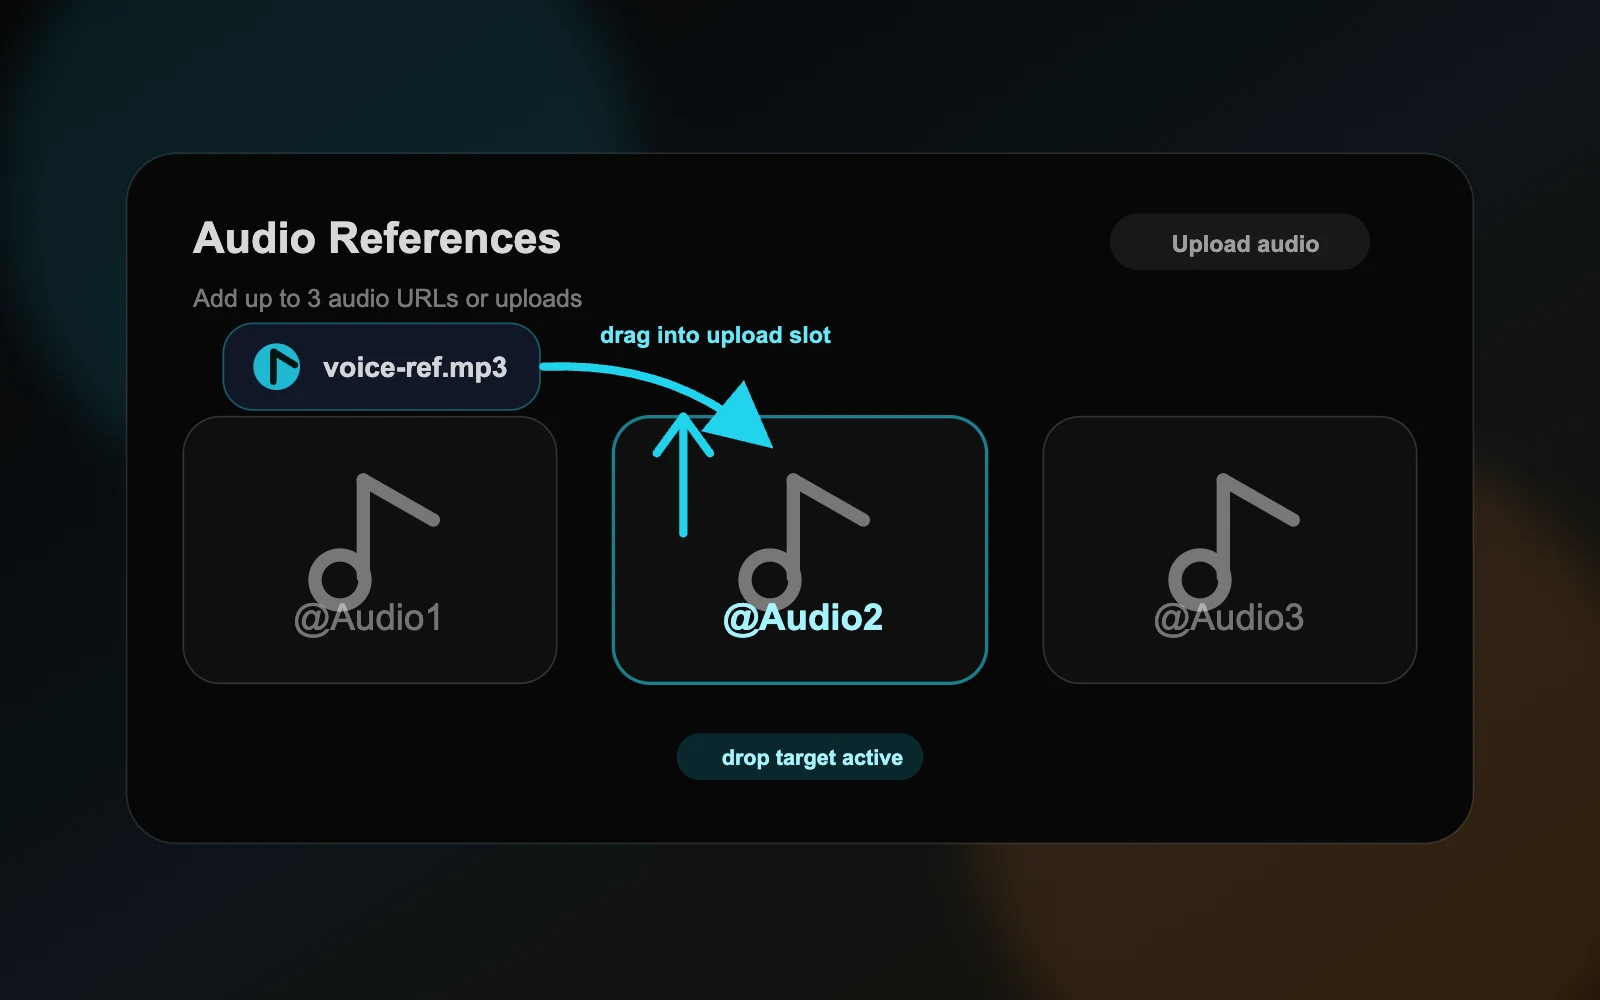
  2. Kontrol Seed Audio 1.0 untuk menambahkan referensi audio atau satu referensi gambar
    02

    Tambahkan referensi opsional

    Gunakan hingga tiga referensi audio untuk arah suara atau gaya, atau satu gambar untuk memandu mood dan konteks scene.

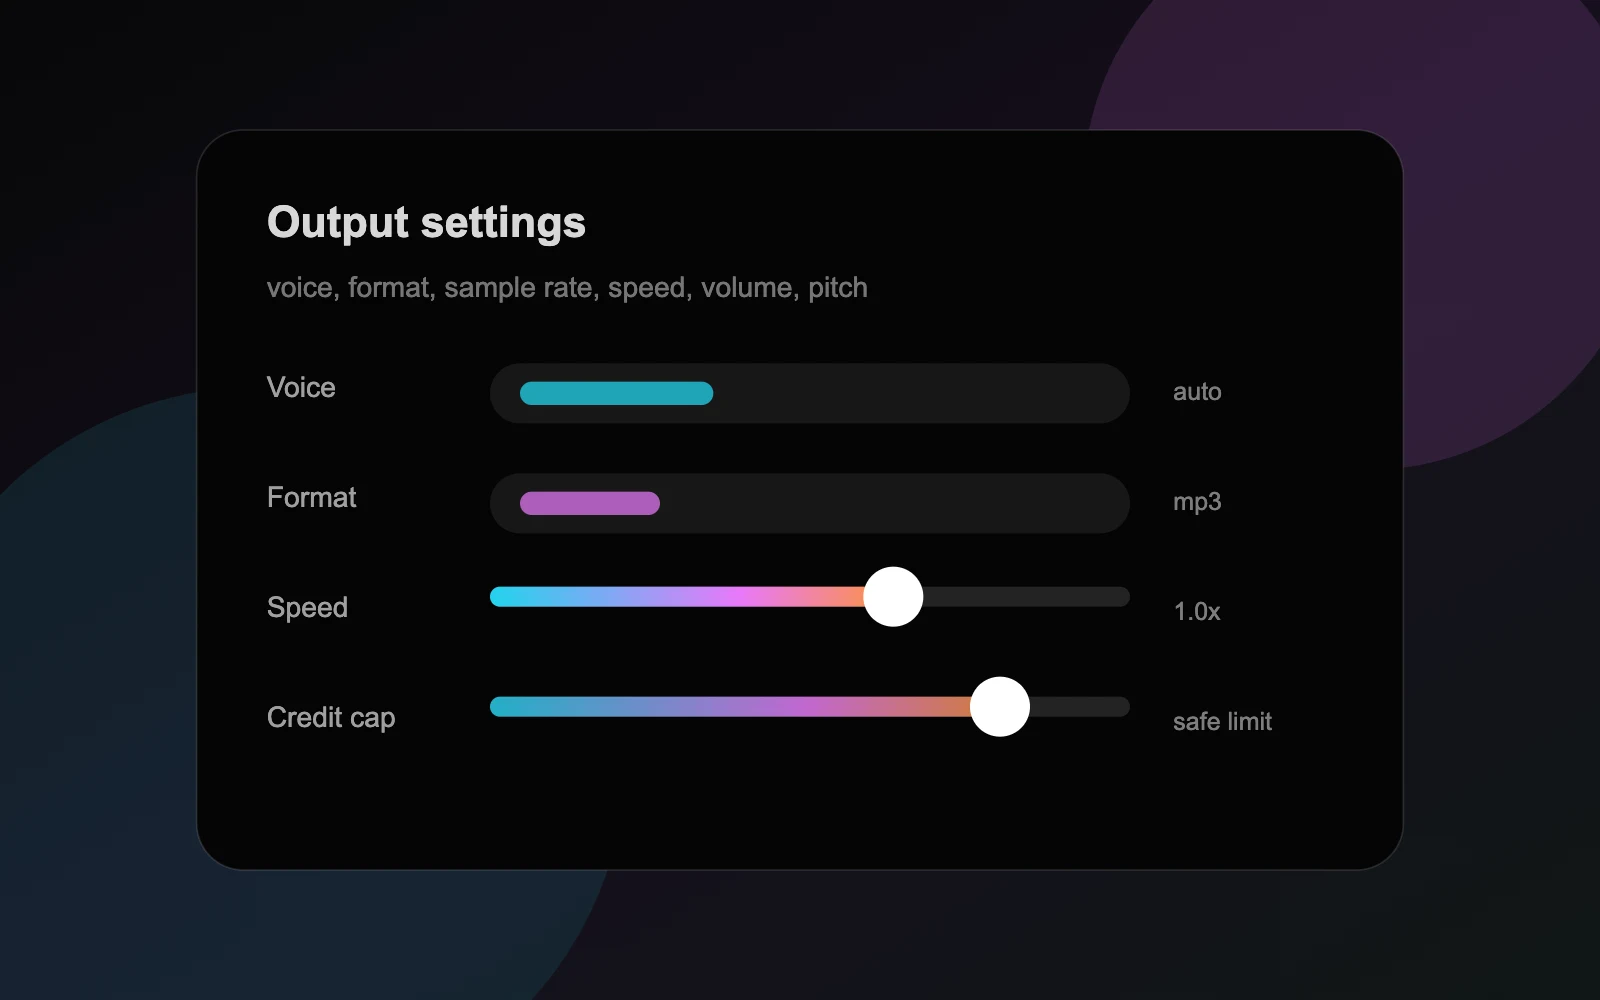
  3. Pengaturan output Seed Audio 1.0 untuk voice, format, speed, volume, pitch, dan batas kredit
    03

    Pilih pengaturan output

    Pilih voice, format output, sample rate, speed, volume, pitch, dan batas kredit maksimum sebelum generate.

  4. Hasil audio Seed Audio 1.0 dengan kontrol pemutaran, salin tautan, unduh, dan regenerate
    04

    Generate dan tinjau

    Jalankan draft pendek terlebih dahulu, dengarkan kejernihan suara dan keseimbangan layer, lalu salin, unduh, atau revisi hasilnya.

Formula prompt

Scene + pembicara + emosi + bahasa + ambiens + BGM + efek suara + timing.

Dibuat untuk alur produksi nyata

Apa yang dapat Anda buat dengan Seed Audio 1.0?

Dari satu brief produksi, buat foley dengan waktu yang presisi, musik orisinal, dialog multibahasa, dan suara berizin yang dapat digunakan kembali.

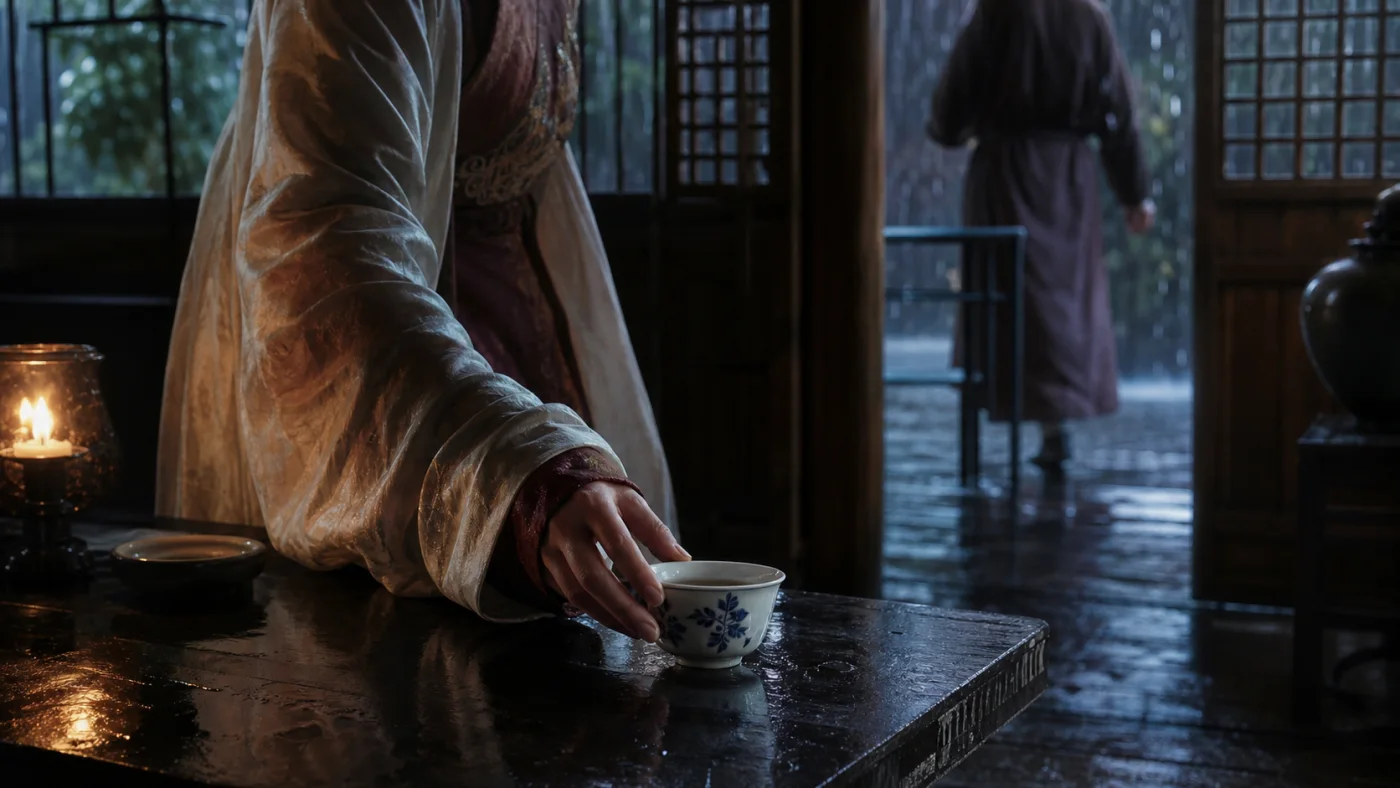
Cangkir porselen di rumah teh bersejarah saat hujan
01Drama pendekVideo makananPascaproduksi AI

Suara Adegan & Foley

Ubah daftar shot menjadi langkah kaki, kain, properti, dan ambience siap edit untuk drama pendek, video makanan, serta pascaproduksi video AI.

Brief produksi

Buat adegan foley murni berdurasi 12 detik di rumah teh kayu saat hujan: lengan sutra menggesek meja, tiga langkah sepatu kulit mendekat, pintu geser terbuka, lalu cangkir porselen diletakkan di atas kayu. Tanpa dialog atau musik.

Audio yang dihasilkan

Hujan di Rumah Teh

0:12
0:00
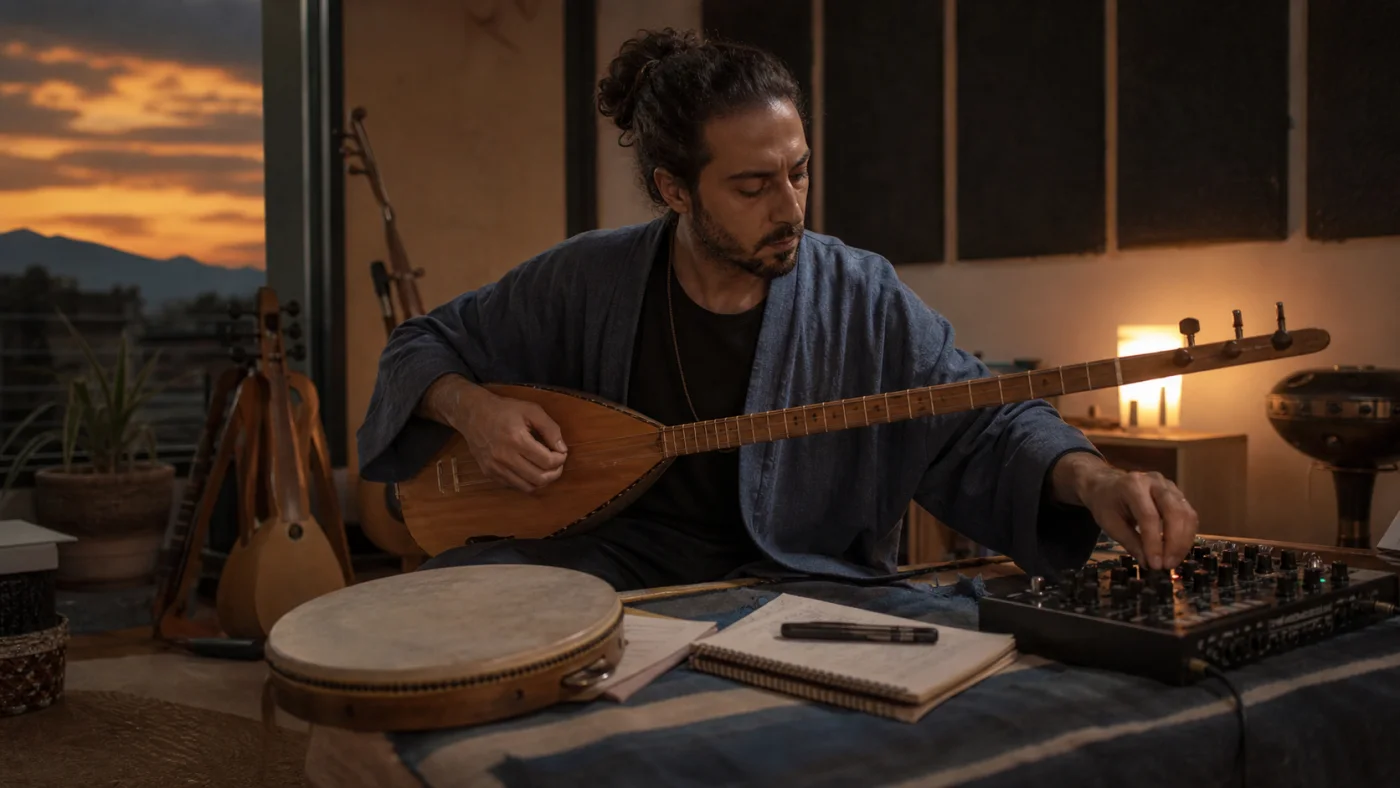
Komposer membuat musik instrumental yang terinspirasi Jalur Sutra
02SoundtrackMusik iklanGaya regional

Musik AI

Hasilkan soundtrack, hook, dan musik latar orisinal untuk film, iklan, serta format regional tanpa mencari-cari di pustaka stok.

Brief produksi

Buat musik sinematik untuk perjalanan malam di Jalur Sutra dengan kecapi petik, frame drum, dan bass modern. Bangun menuju hook yang berkesan pada detik kedelapan. Instrumental saja.

Audio yang dihasilkan

Jalur Sutra Setelah Gelap

0:16
0:00
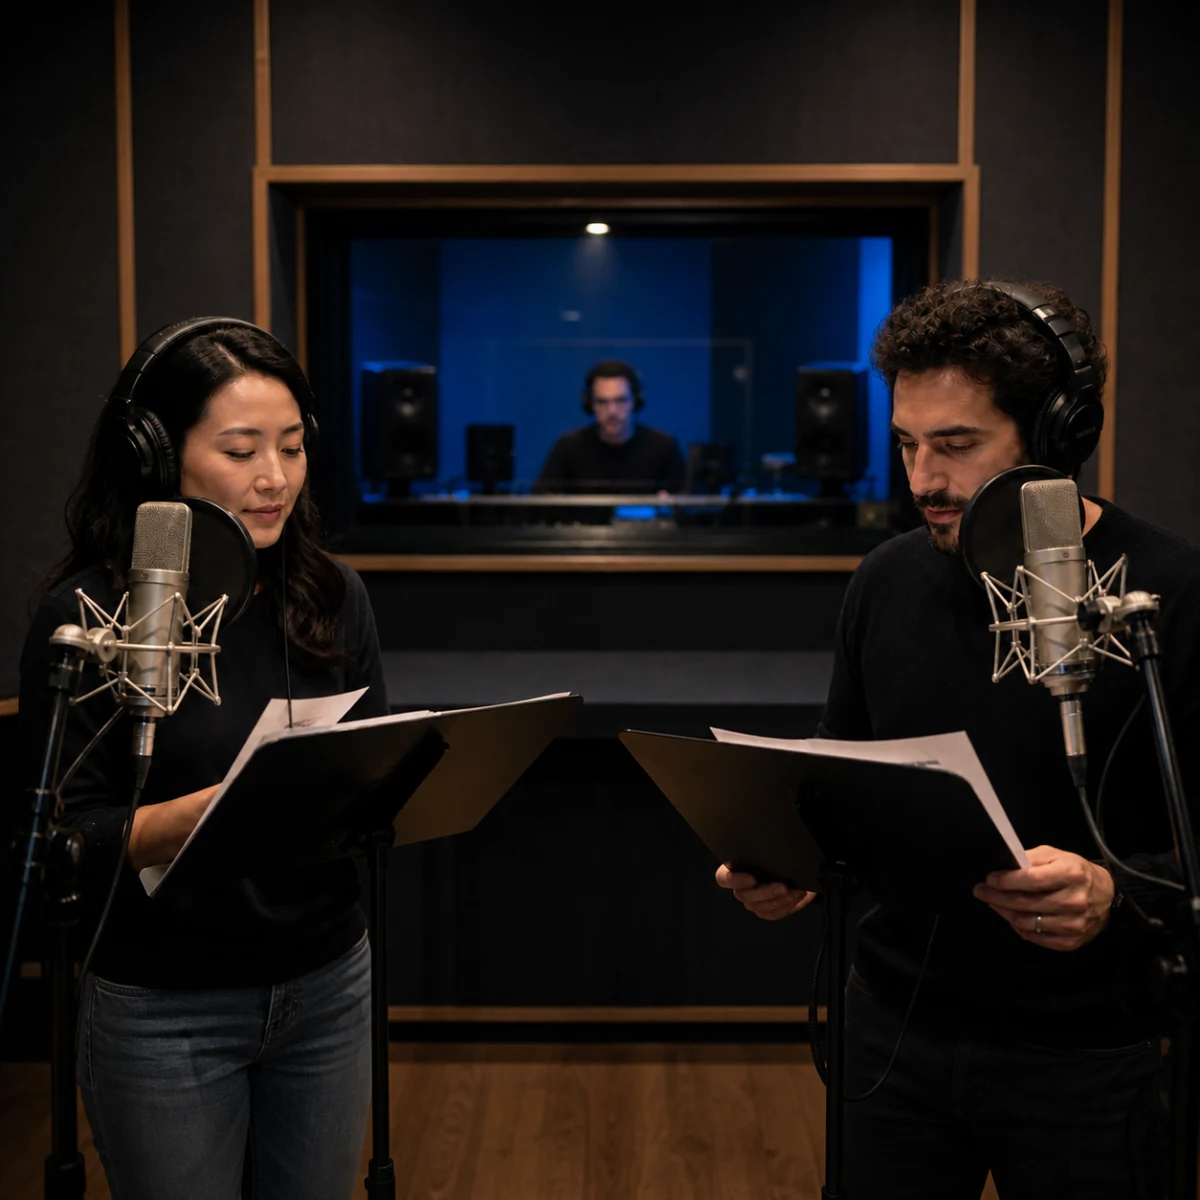
Dua pengisi suara merekam dialog multibahasa di studio sulih suara
03LokalisasiSulih suaraVoice-over komersial

TTS & Dialog Multibahasa

Lokalkan dialog, iklan, dan narasi dengan peran yang berbeda, emosi terkendali, serta penyampaian alami—bukan pembacaan datar dengan satu suara.

Brief produksi

Di pelabuhan sebelum fajar, buat percakapan dua karakter yang sama dan tenang dalam bahasa Italia dan Mandarin. Pertahankan pelafalan alami, ambience pelabuhan yang lembut, dan tanpa musik.

Versi bahasa

Cahaya Pelabuhan · Italia

0:14
0:00
Narator berizin merekam pustaka suara yang dapat digunakan kembali
04Konsistensi karakterSuara merekProduksi serial

Kloning Suara

Pertahankan konsistensi suara karakter atau merek yang telah diizinkan di berbagai episode, kampanye, dan pasar sambil mengubah naskah sesuai kebutuhan.

Brief produksi

Gunakan @Audio1 sebagai referensi suara berizin. Pertahankan identitas yang hangat, tempo terukur, dan aksen lembut saat membacakan: ‘Every new chapter begins with one clear breath.’

Perbandingan suara

Referensi berizin

Waktu Tenang · Asli

0:09
0:00

Variasi yang dihasilkan

Bab Berikutnya · Kloning

0:07
0:00
Hanya kloning suara milik Anda atau suara yang telah Anda dapatkan izin eksplisit untuk digunakan.

Seed Audio 1.0 vs traditional TTS

How Seed Audio 1.0 differs from traditional text-to-speech

Traditional TTS is designed to turn written text into spoken voice. Seed Audio 1.0 is designed for broader audio generation, combining dialogue, performance direction, ambience, music, and sound effects in one sound-scene workflow.

Feature comparison between Seed Audio 1.0 and traditional text-to-speech systems
CapabilitySeed Audio 1.0Traditional TTS (early commercial TTS and basic speech synthesis)
Core positioningScene-level audio creationText-to-speech
Generated contentSpoken dialogue + background music + sound effects + ambience, generated and mixed in one passVoice only (a single speech track)
Multiple speakersNative support for generating coordinated multi-character dialogue, emotion, and pacing in one passUsually requires repeated calls with different voices, followed by manual alignment and mixing
Background music & sound effectsGenerated with the dialogue and automatically matched to its emotion and timelineNot included; requires separate music models, sound libraries, and a DAW
Input methodText prompt / reference audio (up to 3 clips) / reference imageMainly text + a preset voice; some systems support basic references
Voice cloningZero-shot cloning from a short uploaded reference clip (about 30 seconds or less)Often requires fine-tuning or training, or relies on a limited voice library
Emotion & expressiveness controlDescribe emotion, tone, accent, and pacing directly in natural languagePrimarily controlled through SSML tags or limited parameters, with a narrower expressive range
Timeline controlFine timestamp control over when dialogue appearsGenerally not available
Output formatA fully mixed, non-streaming audio track up to about 2 minutes per generationA single voice file that requires music and sound effects to be added later
Best suited forAudio drama, short-form dubbing, ads, game audio, podcast cold opens, video narration, and other complete sound scenesAudiobook reading, navigation, customer service, simple narration, and other voice-only needs
Workflow changeOne prompt → finished audio track, substantially reducing post-production mixingGenerate speech → find music → find sound effects → align and mix manually

Traditional TTS remains the simpler choice when you only need predictable speech. Choose Seed Audio 1.0 when the surrounding scene and sound design are part of the output.

Alur kerja langsung

Dari ide adegan hingga desain suara berlapis.

Beralih dari ide suara ke arahan adegan lengkap: karakter, emosi, lokasi, dialog, musik, ambiens, dan efek dalam satu prompt.

01

Jelaskan adegan suara

Mulai dengan karakter, emosi, lokasi, waktu, dialog, suasana musik, dan efek yang harus ada.

02

Biarkan model menyusun lapisan

Seed Audio 1.0 dirancang untuk mensintesis dialog, nada emosional, aksen asli, ambiens, BGM, dan efek suara.

03

Gunakan di seluruh format kreatif

Bentuk arahan audio untuk film pendek, iklan, podcast, game, konten pembelajaran, dan proyek lainnya.

Teknologi Seed Audio 1.0

Model suara yang diposisikan melampaui text-to-speech biasa.

Seed Audio 1.0 diposisikan untuk adegan audio lengkap: dialog multi-karakter, emosi, nada, aksen, ambiens, BGM, dan Foley.

Multi-pembicara

kontinuitas suara untuk adegan yang lebih panjang

Teks / gambar / audio

prompt multimodal untuk kreasi audio

Generasi audio all-in-one

Komposisi beberapa lapisan suara sekaligus, bukan menjahit suara, musik, ambiens, dan efek di alat terpisah.

Kontrol emosi dan aksen

Pandu nada, penyampaian emosional, dialek, dan aksen alami sambil menjaga suara tetap dikenal.

Ambiens adegan dan BGM

Hasilkan lingkungan, BGM, suara ruangan, cuaca, keramaian, atau tekstur kota bersama dialog.

Adegan audio lebih panjang

Seed Audio 1.0 dibangun untuk adegan suara panjang, termasuk generasi sesi untuk dialog, ambiens, dan urutan musik.

Kemungkinan kreatif

Adegan suara untuk video, game, pendidikan, dan iklan.

Seed Audio 1.0 paling menarik ketika proyek membutuhkan lebih dari narasi: adegan akustik lengkap.

Desain suara film pendek

Draf dialog, ketukan emosional, Foley, ambiens, dan musik untuk papan cerita.

Kreatif pemasaran

Buat arahan suara siap kampanye untuk demo produk, klip sosial, dan iklan lokal.

Prototipe game dan XR

Prototipe loop ambien, suara karakter, suara UI, dan momen sinematik.

Konten pembelajaran

Bangun pelajaran berbasis skenario, percakapan karakter, dan penjelasan imersif dengan isyarat suara spasial.

Dialog

Pengiriman multi-karakter dengan nada emosional

Ambiens

Hujan, lalu lintas, ruangan, keramaian, dan lingkungan alami

Foley

Langkah kaki, benturan, pintu, tekstur, dan waktu

Harga

Pilih paket Seed Audio 1.0 yang tepat

Berlangganan untuk nilai terbaik, atau beli kredit saat Anda perlu isi ulang fleksibel.

Lihat detail harga Seed Audio 1.0
Free
US$0

Coba Seed Audio 1.0 dengan kredit pendaftaran. Cocok untuk menguji prompt dan adegan pendek.

  • 10 kredit gratis
  • Hingga ~8 detik per generasi
  • Hingga 2 mnt audio per generasi
  • Akses API
  • Dukungan prioritas
Pro
Hemat US$39,98
US$16,66US$19,99/mo

Pilihan tahunan terbaik untuk kreator dengan kebutuhan audio berkelanjutan.

  • 30.000 kredit per tahun
  • Hingga ~400 menit audio total
  • Semua yang ada di Free
  • Lebih banyak ruang untuk proyek audio panjang
  • Unggahan suara referensi
  • Dukungan prioritas
  • Maks 2 menit per generasi
  • Seed Audio 1.0 API access — shared credits
Max
Hemat US$99,98
US$41,66US$49,99/mo

Nilai terkuat untuk tim yang mengharapkan generasi audio berat.

  • 90.000 kredit per tahun
  • Hingga ~1.200 menit audio total
  • Semua yang ada di Pro
  • Nilai terbaik untuk generasi volume tinggi
  • Buffer produksi tahunan lebih besar
  • Ramah tim dan agensi
  • Maks 2 menit per generasi
  • Seed Audio 1.0 API access — shared credits
Pertanyaan tentang tagihan, akses, atau kebutuhan kustom?contact@seedaudio.co

FAQ

Pertanyaan yang sering diajukan

Jawaban praktis bagi kreator yang ingin memahami Seed Audio 1.0.

Ciptakan adegan suara yang lebih kaya dengan Seed Audio 1.0.

Ikuti kemampuan model, status akses, dan kasus penggunaan praktis.