01ショートドラマ料理動画AI動画編集
シーンサウンド&フォーリー
ショットリストから、ショートドラマ、料理動画、AI動画のポスト制作に使える足音、衣擦れ、プロップ音、環境音を編集可能な形で生成します。
制作指示
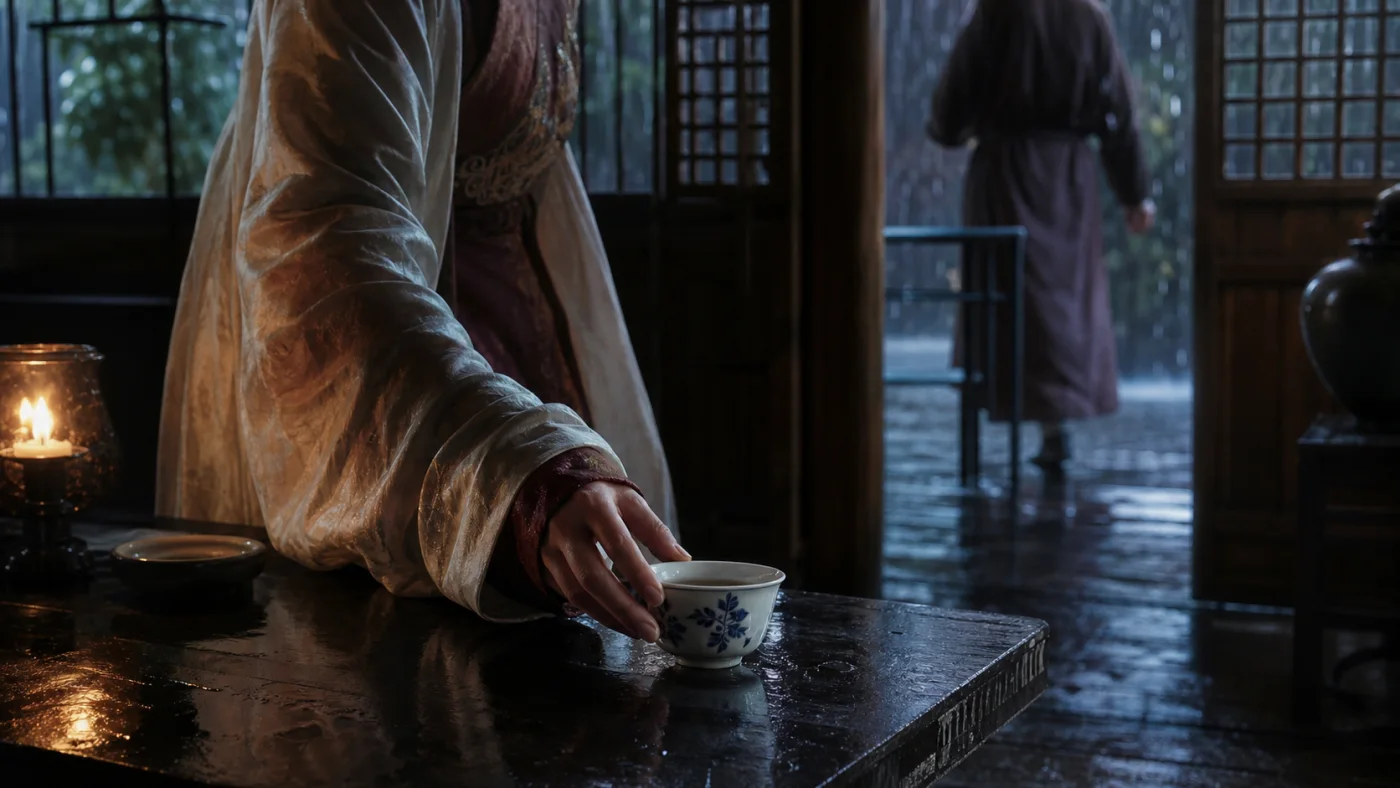
雨の木造茶屋を舞台に、12秒間の純粋なフォーリーを作成。絹の袖が卓上を擦れ、革靴が3歩近づき、引き戸が開き、磁器の茶碗が木の机に置かれる。会話と音楽はなし。
生成オーディオ
雨の茶屋
0:120:00
Seed Audio 1.0 は、完全なサウンドシーンを作成するためのByteDance Seedのオールインワン音声生成モデルです。テキスト、画像、または音声コンテキストを使って、複数話者の対話、感情表現、自然なアクセント、環境音、BGM、foleyスタイルのエフェクトを導けます。
Seed Audio 1.0
シーンプロンプトのプレビュー
プロンプトコンセプト
雨の路地で2人がささやき合い、下には緊張感のあるストリングス、遠くの交通音、足音、最後に金属製のドアが激しく閉まる音。
下のSeed Audio 1.0ワークスペースを使って、プロンプト、任意の参照音声、または1枚の参照画像からサウンドシーンを作成できます。
入力
プロンプト優先の音声生成。必要に応じて追加コントロールを利用できます。
追加設定
入力をより細かくカスタマイズできます。
履歴
最近のSeed Audio 1.0 Preview生成履歴。
生成履歴を見るにはサインインしてください。
モデル概要
Seed Audio 1.0は、ByteDance SeedのマルチモーダルAIオーディオ生成モデルです。テキスト、画像、音声の入力から完全なサウンドシーンを作成し、1つのワークフローで複数話者の会話、表現豊かな声、自然なアクセント、環境音、BGM、フォーリー風の効果音を組み合わせます。音声だけを生成する従来のTTSとは異なります。
プロンプトには話者、タイミング、感情、言語、場所、音楽の方向性、音響イベントをまとめて指定できます。映画的なシーン、多言語会話、広告、ポッドキャスト、ゲームなど、声と周囲のサウンドが一体で機能する必要がある制作に適しています。
Seed Audio 1.0の詳細を見る入力
テキスト、画像、最大3つの音声参照
サウンドレイヤー
会話、声、環境音、音楽、効果音
出力
最長2分の統合されたオーディオシーン
使い方
Seed Audio 1.0をオンラインで使うには、サウンドシーンのプロンプトを書き、必要に応じて音声または画像参照を追加し、出力設定を選んでからSeedAudio.coのワークスペースで生成結果を確認します。
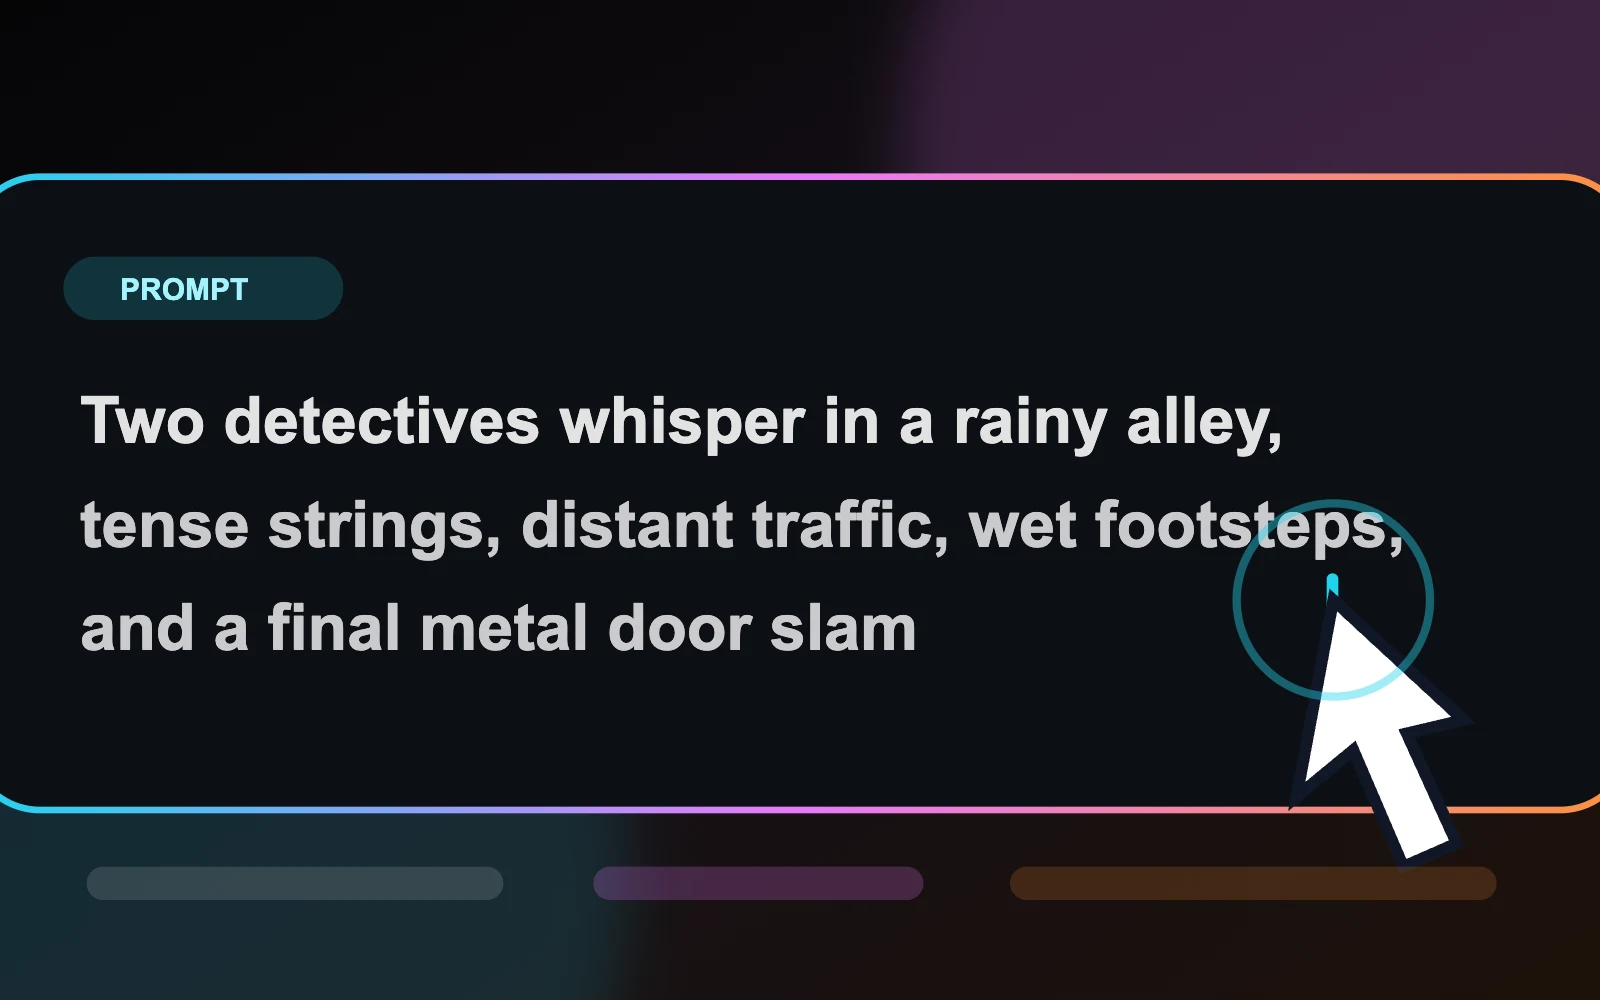
登場人物、言語、感情、場所、会話、アンビエンス、音楽の方向性、必要な音イベントを説明します。
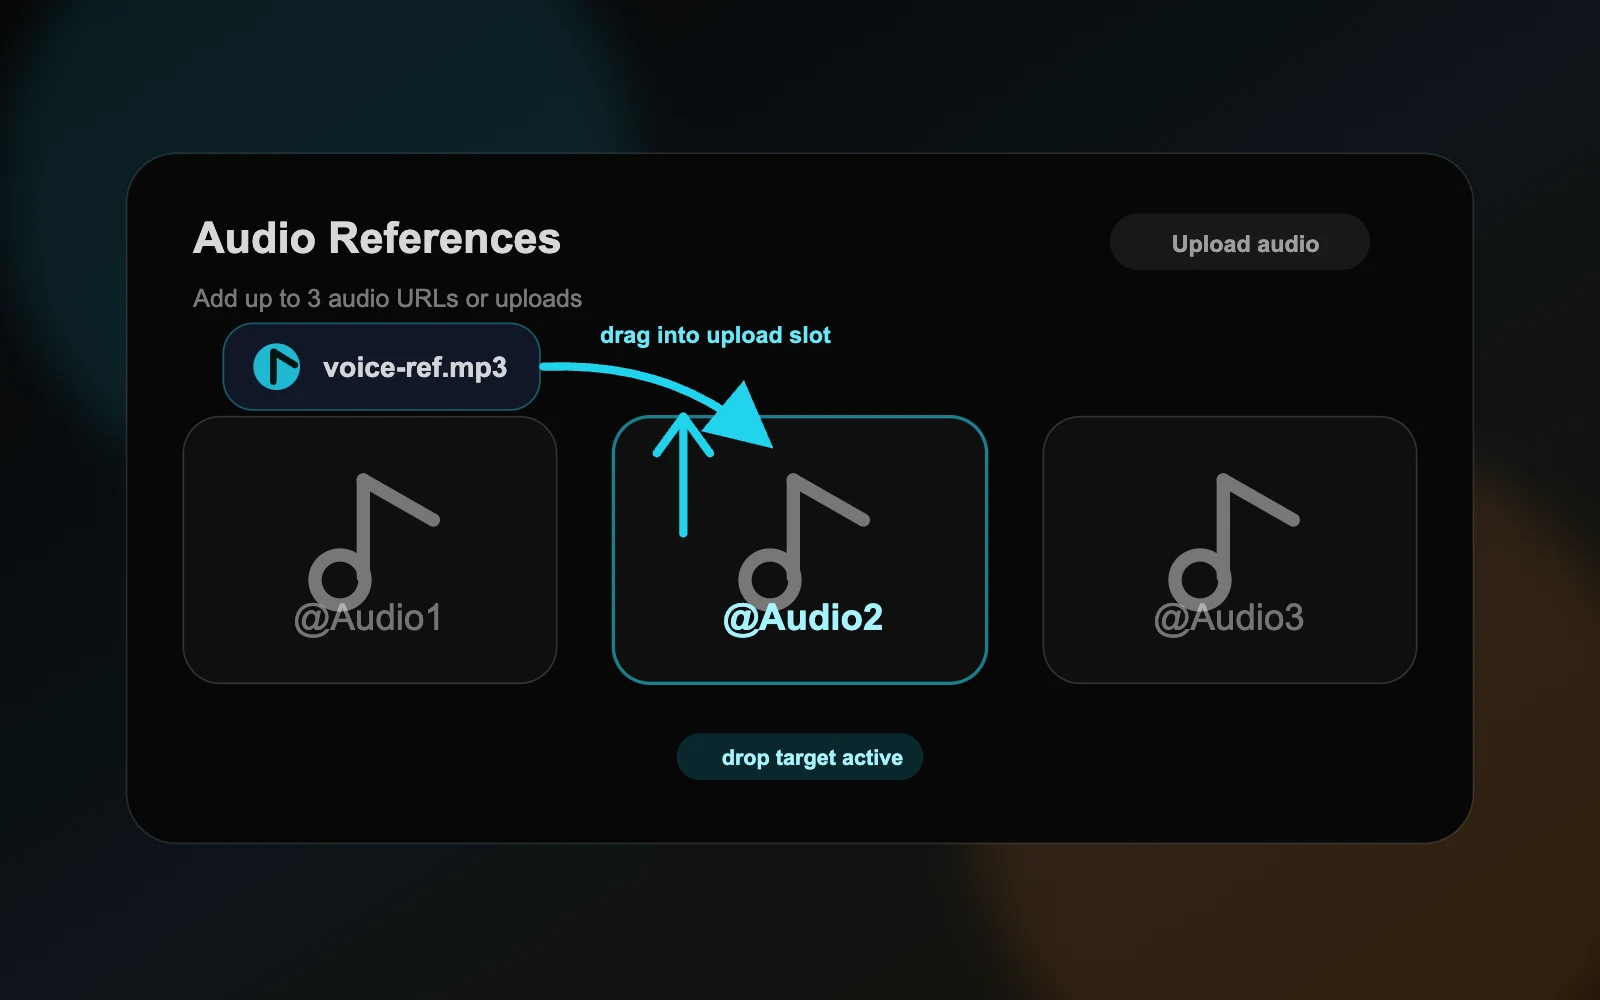
最大3つの音声参照で声やスタイルを導くか、1つの画像参照でムードとシーン文脈を伝えます。
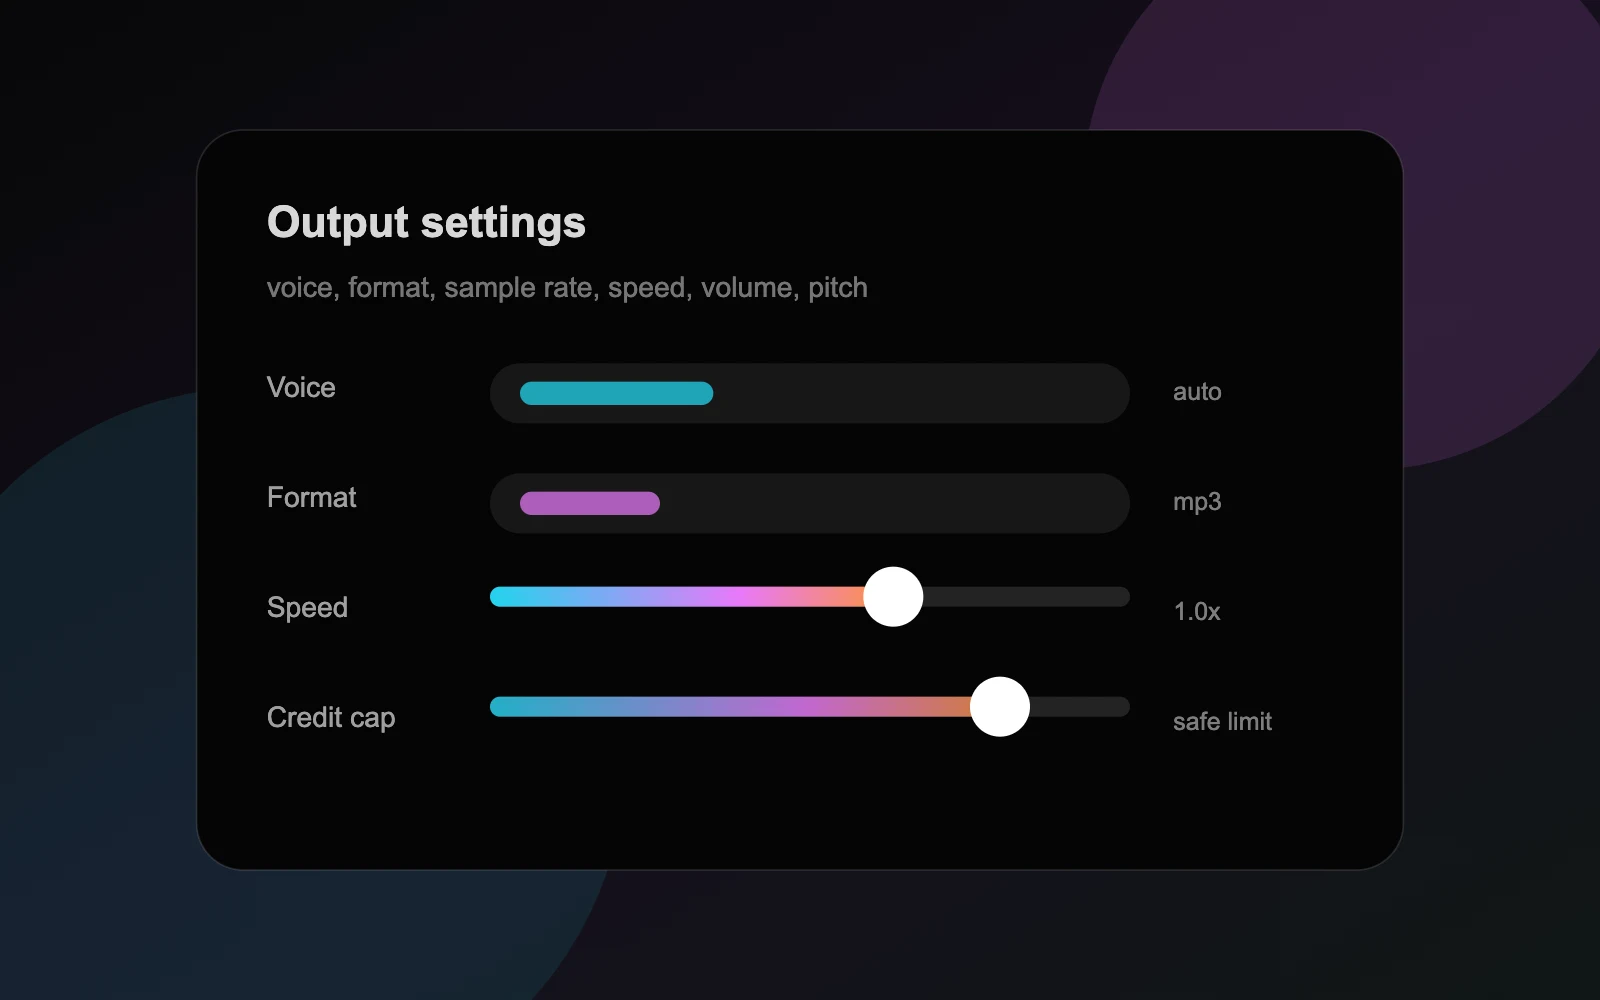
生成前に声、出力形式、サンプルレート、速度、音量、ピッチ、最大クレジット上限を選びます。
まず短いドラフトを生成し、声の明瞭さとレイヤーのバランスを確認してから、コピー、ダウンロード、または修正します。
プロンプト式
シーン + 話者 + 感情 + 言語 + アンビエンス + BGM + 効果音 + タイミング。
実際の制作ワークフローのために
1つの制作指示から、タイミングを精密に合わせたフォーリー、オリジナル音楽、多言語の会話、再利用可能な許諾済みボイスを生成できます。
ショットリストから、ショートドラマ、料理動画、AI動画のポスト制作に使える足音、衣擦れ、プロップ音、環境音を編集可能な形で生成します。
雨の木造茶屋を舞台に、12秒間の純粋なフォーリーを作成。絹の袖が卓上を擦れ、革靴が3歩近づき、引き戸が開き、磁器の茶碗が木の机に置かれる。会話と音楽はなし。
雨の茶屋
0:12
ストック素材を探し回ることなく、映画、広告、地域向けコンテンツのためのオリジナル劇伴、フック、BGMを制作します。
撥弦楽器、フレームドラム、モダンなベースを組み合わせた、シルクロードの夜のドライブを思わせる映画音楽を作曲。8秒地点で印象的なフックに展開。インストゥルメンタルのみ。
シルクロード・アフターダーク
0:16
平坦な一人読みではなく、明確な役割、感情の制御、自然な母語表現で会話、広告、ナレーションをローカライズします。
夜明け前の港で、抑制の効いた二人の会話をイタリア語と中国語で同じように制作。自然な発音と控えめな港の環境音を保ち、音楽は入れない。
港の灯り・イタリア語
0:14
許諾済みのキャラクターやブランドの声を、台本を自由に変更しながら、エピソード、キャンペーン、市場をまたいで一貫させます。
@Audio1を許諾済みの音声リファレンスとして使用。温かい声の個性、落ち着いたペース、柔らかなアクセントを保ち、『Every new chapter begins with one clear breath.』と読み上げる。
許諾済みリファレンス
静かな時間・オリジナル
0:09生成バリエーション
次の章・クローン
0:07Seed Audio 1.0 vs traditional TTS
Traditional TTS is designed to turn written text into spoken voice. Seed Audio 1.0 is designed for broader audio generation, combining dialogue, performance direction, ambience, music, and sound effects in one sound-scene workflow.
| Capability | Seed Audio 1.0 | Traditional TTS (early commercial TTS and basic speech synthesis) |
|---|---|---|
| Core positioning | Scene-level audio creation | Text-to-speech |
| Generated content | Spoken dialogue + background music + sound effects + ambience, generated and mixed in one pass | Voice only (a single speech track) |
| Multiple speakers | Native support for generating coordinated multi-character dialogue, emotion, and pacing in one pass | Usually requires repeated calls with different voices, followed by manual alignment and mixing |
| Background music & sound effects | Generated with the dialogue and automatically matched to its emotion and timeline | Not included; requires separate music models, sound libraries, and a DAW |
| Input method | Text prompt / reference audio (up to 3 clips) / reference image | Mainly text + a preset voice; some systems support basic references |
| Voice cloning | Zero-shot cloning from a short uploaded reference clip (about 30 seconds or less) | Often requires fine-tuning or training, or relies on a limited voice library |
| Emotion & expressiveness control | Describe emotion, tone, accent, and pacing directly in natural language | Primarily controlled through SSML tags or limited parameters, with a narrower expressive range |
| Timeline control | Fine timestamp control over when dialogue appears | Generally not available |
| Output format | A fully mixed, non-streaming audio track up to about 2 minutes per generation | A single voice file that requires music and sound effects to be added later |
| Best suited for | Audio drama, short-form dubbing, ads, game audio, podcast cold opens, video narration, and other complete sound scenes | Audiobook reading, navigation, customer service, simple narration, and other voice-only needs |
| Workflow change | One prompt → finished audio track, substantially reducing post-production mixing | Generate speech → find music → find sound effects → align and mix manually |
Traditional TTS remains the simpler choice when you only need predictable speech. Choose Seed Audio 1.0 when the surrounding scene and sound design are part of the output.
シンプルなワークフロー
音のアイデアから完全なシーン指示へ。キャラクター、感情、場所、対話、音楽、環境音、エフェクトを1つのプロンプトで定義します。
キャラクター、感情、場所、タイミング、対話、音楽のムード、シーンに必要なエフェクトから始めます。
Seed Audio 1.0 は、対話、感情的なトーン、自然なアクセント、環境音、BGM、明確なサウンドエフェクトをまとめて合成するよう設計されています。
短編映画、広告、ポッドキャスト、ゲーム、学習コンテンツなど、一貫したサウンドシーンを素早く必要とするプロジェクト向けに音声指示を形作れます。
Seed Audio 1.0 テクノロジー
Seed Audio 1.0 は、複数キャラクターの対話、感情、トーン、アクセント、環境音ベッド、BGM、foleyを1回のクリエイティブ生成で扱う完全な音声シーン向けに位置づけられています。
Multi-speaker
より長い生成シーンでの声の一貫性
Text / image / audio
音声制作のためのマルチモーダルプロンプト
音声、音楽、環境音、エフェクトを別々のツールでつなぎ合わせるのではなく、複数の音レイヤーを一度に構成します。
トーン、感情表現、方言、自然に聞こえるアクセントを導きながら、繰り返し登場する声を文脈をまたいで認識しやすく保ちます。
対話と並行して、環境ベッド、BGM、ルームトーン、天候、群衆、遠くの街の質感を生成します。
Seed Audio 1.0 は、対話、環境音、音楽付きシーケンスに適したセッション長の生成を含む、長尺のサウンドシーン向けに作られています。
クリエイティブの可能性
Seed Audio 1.0 が特に面白いのは、ナレーション以上のもの、つまり声、ムード、空間、出来事を含む完全な音響シーンが必要なプロジェクトです。
絵コンテやプリビジュアライゼーション向けに、対話、感情のビート、foley、環境音、音楽を下書きできます。
製品デモ、ソーシャルクリップ、ローカライズ広告向けに、キャンペーンで使える音声指示を作成できます。
最終的な音声制作の前に、環境ループ、キャラクターボイス、UIサウンド、シネマティックな瞬間をプロトタイプ化できます。
シナリオ型レッスン、キャラクター会話、空間的な音の合図を含む没入型解説を作成できます。
感情的なトーンを伴う複数キャラクターの表現
雨、交通音、部屋、群衆、自然なベッド音
足音、衝撃音、ドア、質感、タイミング
料金
最もお得に使うならサブスクリプション、柔軟に追加したい場合はcreditsを購入できます。すべてのプランで、オプションの参照素材を使ったプロンプトベースのSeed Audio生成に対応しています。
Seed Audio 1.0の料金詳細を見る登録ボーナスで Seed Audio 1.0 を試せます。短いシーンやプロンプト検証に最適です。
継続的な音声ニーズがあるクリエイターに最適な年額プラン。
大量の音声生成を見込むチームに最も強い価値を提供します。
FAQ
Seed Audio 1.0 を理解し、AI audio generationに活用したいクリエイター向けの実用的な回答です。
対話、環境音、音楽、サウンドエフェクトを横断するマルチモーダルAI audio generationについて、モデルの機能、アクセス状況、実用的なユースケースを追えます。