Seed Audio 1.0
Cadastrar
Gerador de áudio IA Seed Audio 1.0

Gerador de áudio IA Seed Audio 1.0

Seed Audio 1.0 é o modelo tudo-em-um da ByteDance Seed para criar cenas sonoras completas. Use texto, imagem ou áudio para guiar diálogos, emoções, sotaques, ambientes, música e efeitos Foley.

2 min
janela de geração de áudio por sessão
Um prompt
controla diálogo, tom, ambiente, BGM e SFX
Multimodal
texto, imagem e áudio para cenas sonoras

Seed Audio 1.0

Prévia do prompt de cena

Geração de áudio
Sala de controle abstrata de geração de áudio IA

Conceito do prompt

Duas vozes sussurram em um beco chuvoso, cordas tensas ao fundo, trânsito distante, passos e uma porta metálica batendo.

Pistas de diálogo
Camada BGM
Ambiente + SFX

Comece a gerar Seed Audio 1.0 online.

Use o espaço de trabalho abaixo para criar cenas sonoras a partir de um prompt, áudio de referência ou imagem.

Entrada

Geração de áudio por prompt com controles opcionais.

Prompt*
83/2048

Configurações adicionais

Personalize sua entrada com mais controle.

Histórico

Suas gerações recentes do Seed Audio 1.0 Preview.

Faça login para ver seu histórico.

Visão geral do modelo

O que é o Seed Audio 1.0?

O Seed Audio 1.0 é o modelo multimodal de geração de áudio com IA da ByteDance Seed, criado para produzir cenas sonoras completas a partir de texto, imagem e áudio. Em um único fluxo, ele combina diálogos com vários falantes, vozes expressivas, sotaques naturais, ambiente, música de fundo e efeitos sonoros no estilo foley, em vez de gerar apenas fala.

Os prompts podem descrever falantes, tempo, emoção, idioma, local, direção musical e eventos sonoros em conjunto. O modelo é útil para cenas cinematográficas, diálogos localizados, anúncios, podcasts, jogos e outros projetos em que a voz e a paisagem sonora precisam funcionar como uma unidade.

Saiba mais sobre o Seed Audio 1.0

Entradas

Texto, imagem e até 3 referências de áudio

Camadas sonoras

Diálogo, voz, ambiente, música e efeitos

Saída

Uma cena de áudio coordenada de até 2 minutos

Como usar

Como usar Seed Audio 1.0 online.

Para usar o Seed Audio 1.0 online, escreva um prompt de cena sonora, adicione opcionalmente uma referência de áudio ou imagem, escolha as configurações de saída e gere e revise o áudio no espaço de trabalho do SeedAudio.co.

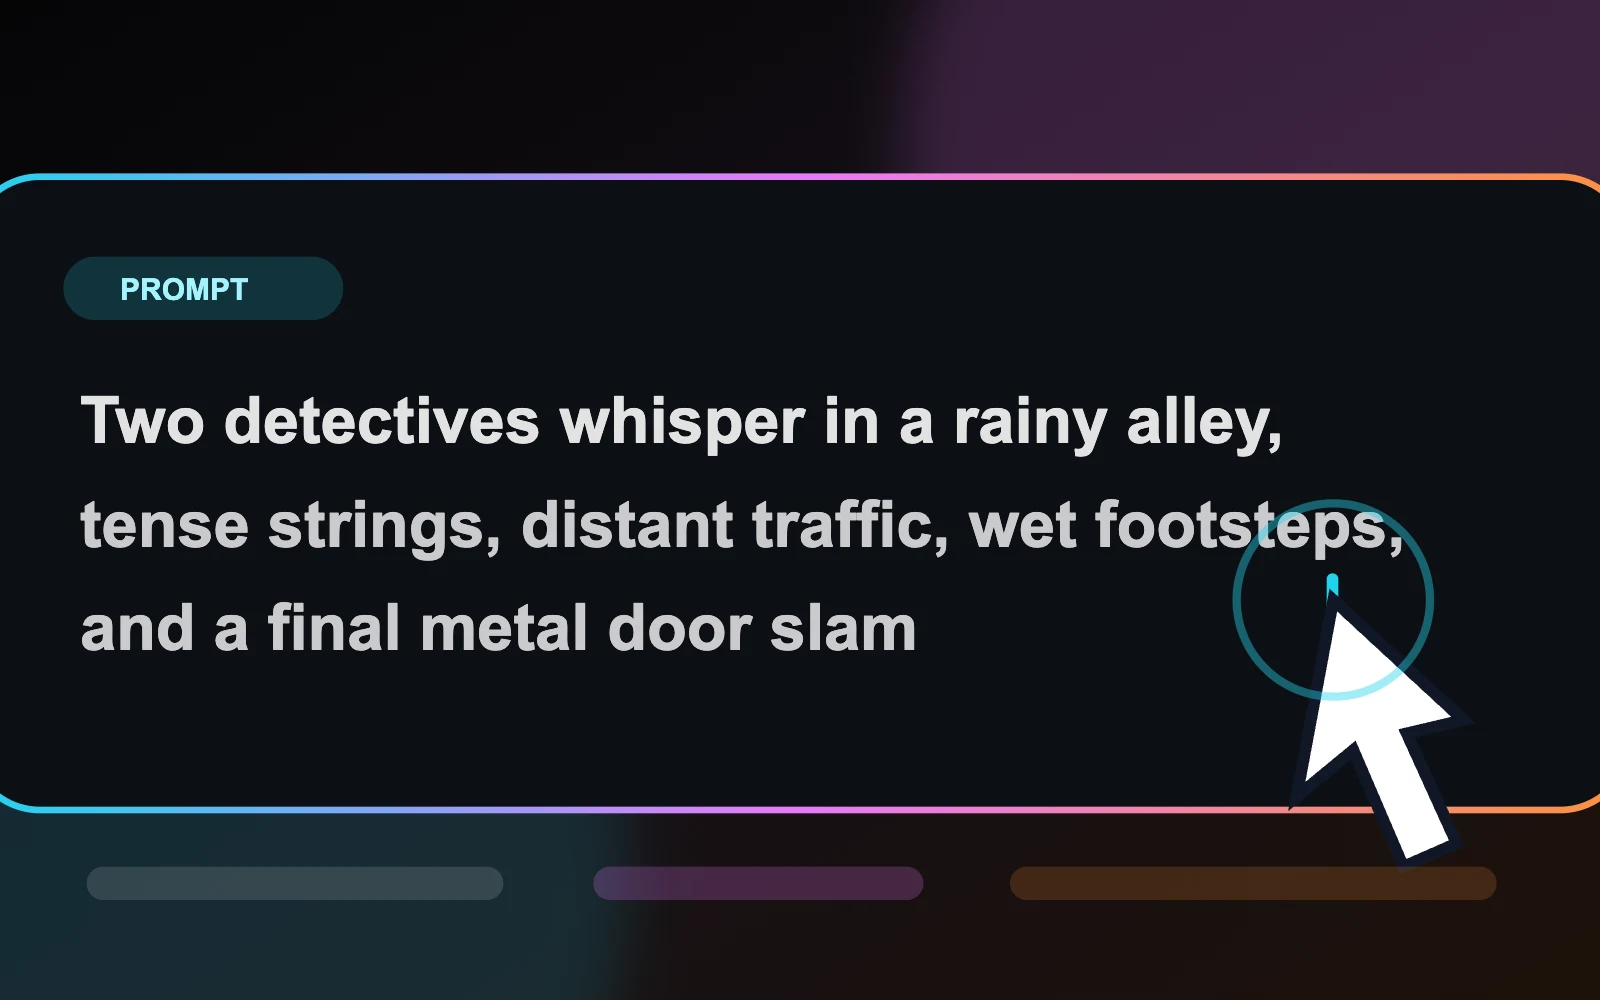
  1. Editor de prompts do Seed Audio 1.0 para escrever um prompt estruturado de cena sonora
    01

    Escreva um prompt de cena sonora

    Descreva personagens, idioma, emoção, local, diálogo, ambiência, direção musical e eventos sonoros desejados.

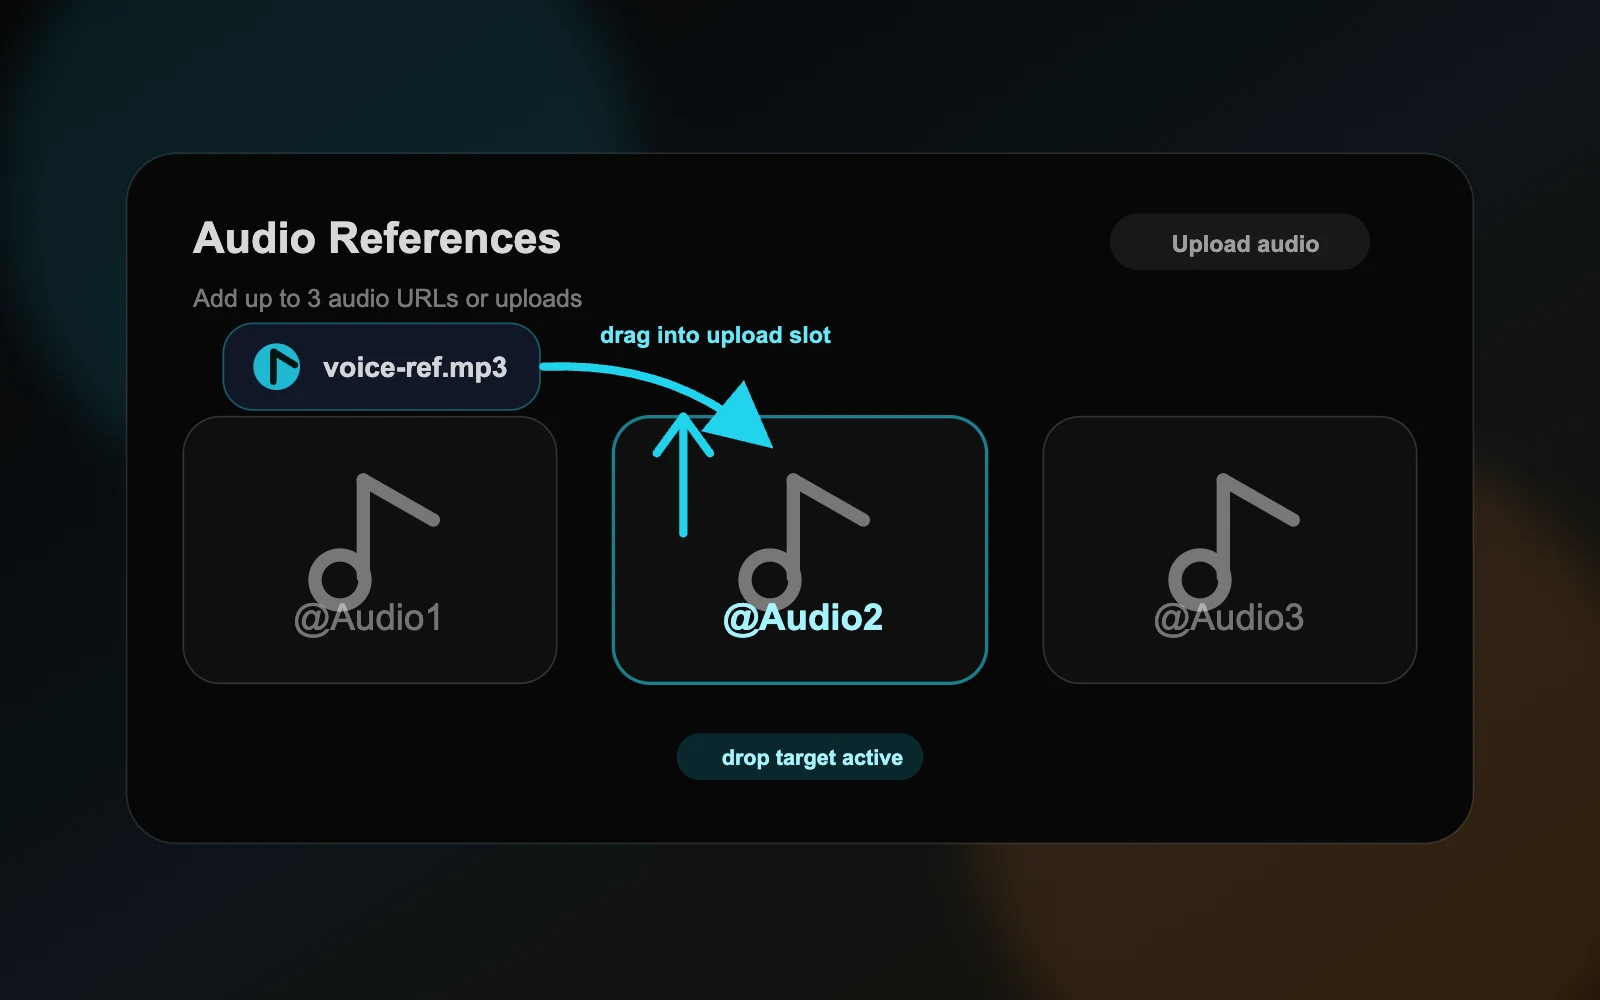
  2. Controles do Seed Audio 1.0 para adicionar referências de áudio ou uma referência de imagem
    02

    Adicione referências opcionais

    Use até três referências de áudio para orientar voz ou estilo, ou uma imagem para guiar o clima e o contexto da cena.

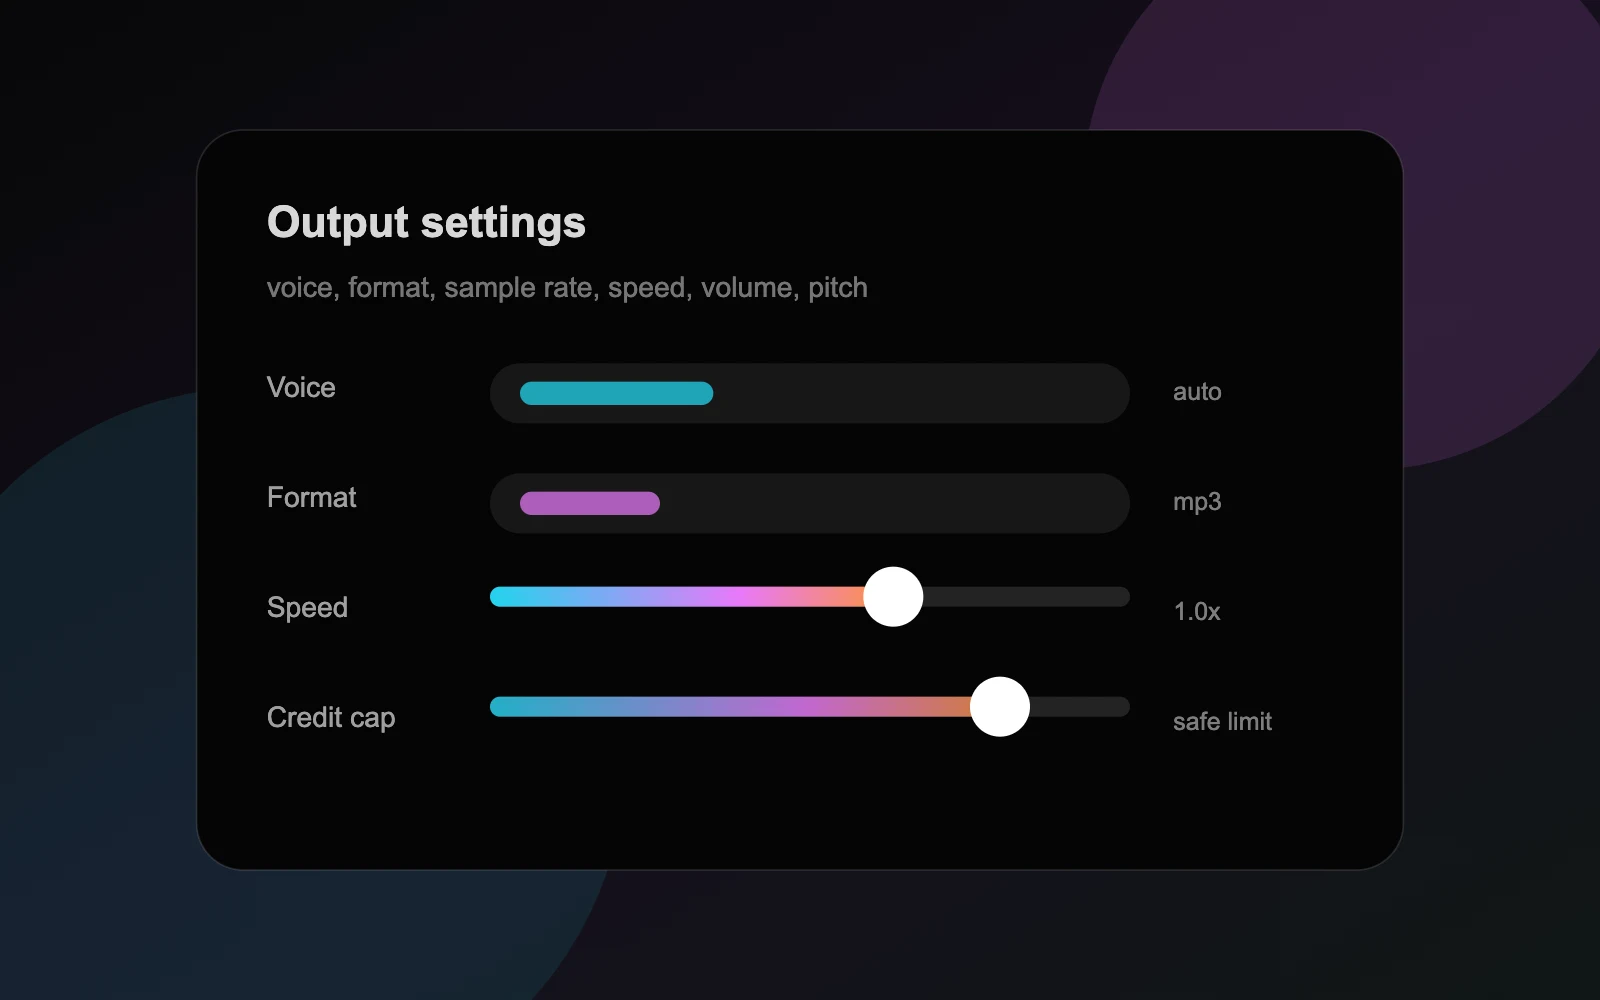
  3. Configurações de saída do Seed Audio 1.0 para voz, formato, velocidade, volume, pitch e limite de créditos
    03

    Escolha configurações de saída

    Selecione voz, formato, taxa de amostragem, velocidade, volume, pitch e limite máximo de créditos antes de gerar.

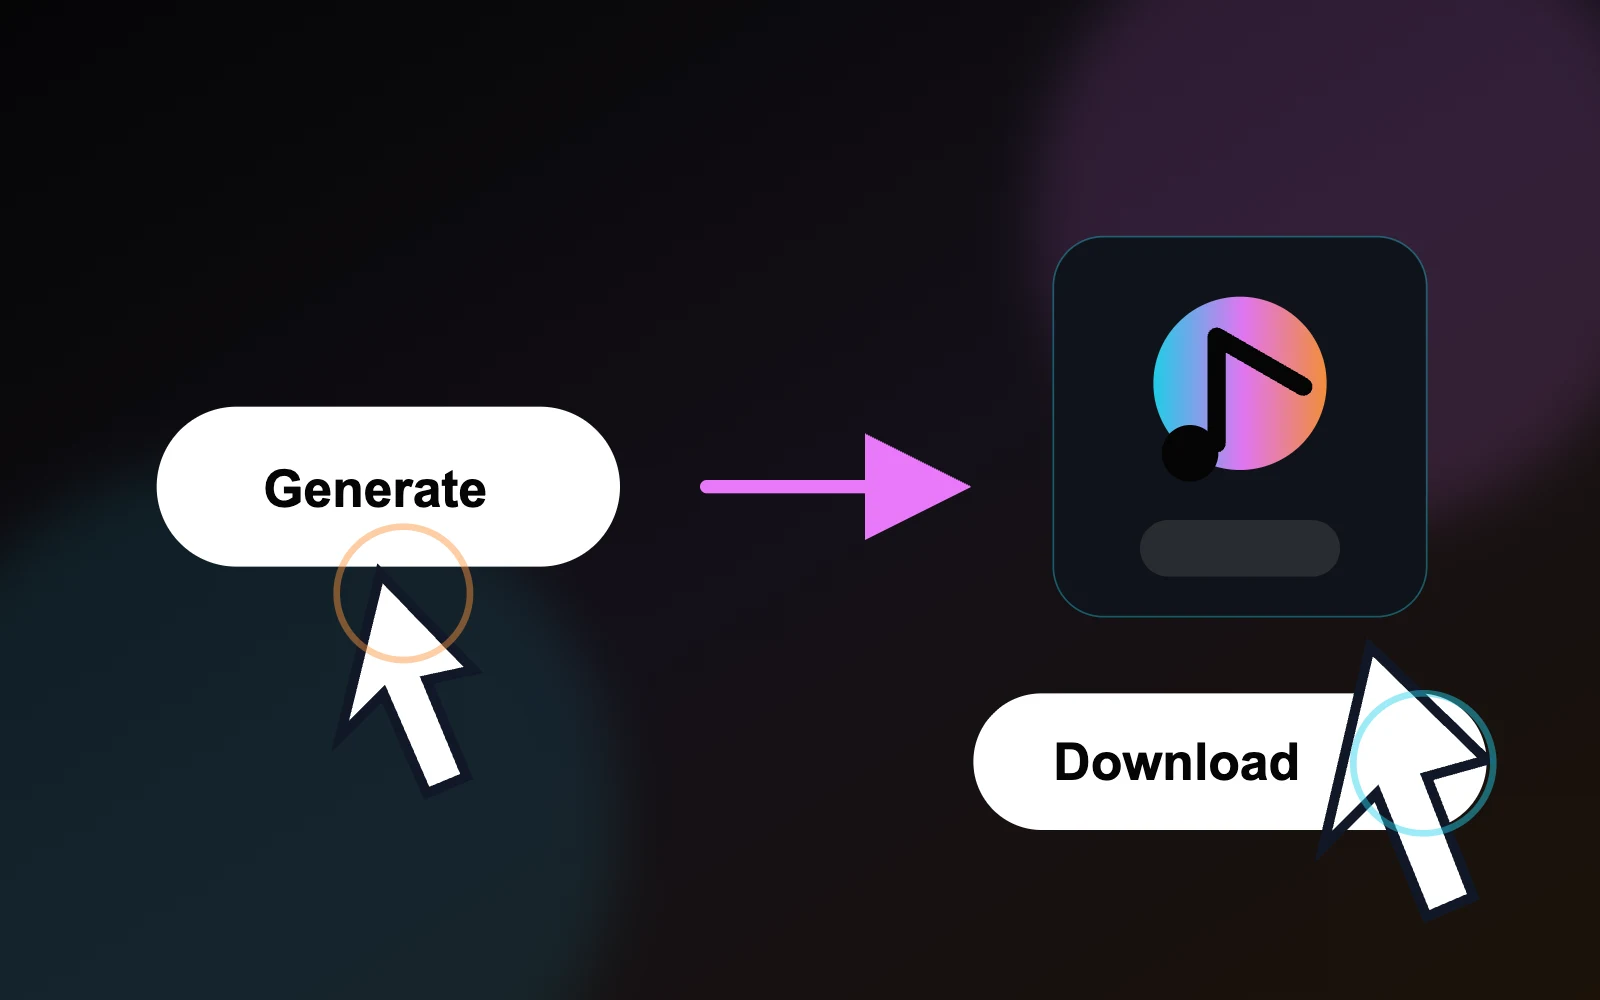
  4. Resultado de áudio gerado pelo Seed Audio 1.0 com reprodução, cópia de link, download e regeneração
    04

    Gere e revise

    Execute primeiro um rascunho curto, ouça a clareza da voz e o equilíbrio das camadas, depois copie, baixe ou revise o resultado.

Fórmula do prompt

Cena + falante + emoção + idioma + ambiência + BGM + efeitos sonoros + timing.

Feito para fluxos de produção reais

O que você pode criar com o Seed Audio 1.0?

A partir de um único briefing, crie foley com sincronização precisa, música original, diálogos multilíngues e vozes autorizadas reutilizáveis.

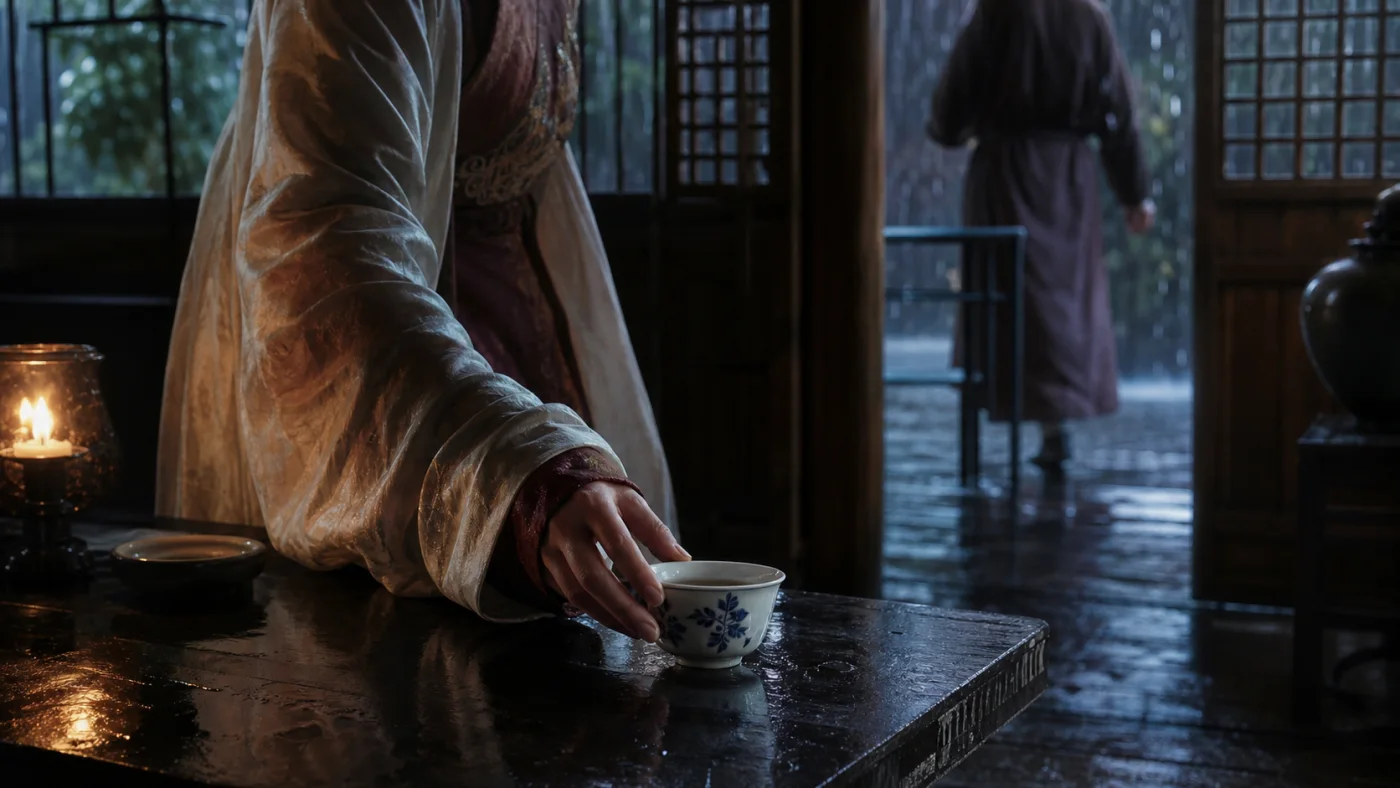
Uma xícara de porcelana em uma casa de chá histórica sob a chuva
01Drama curtoVídeo de culináriaPós-produção com IA

Som de cena e foley

Transforme uma lista de planos em passos, tecidos, objetos e ambientes prontos para edição em dramas curtos, vídeos de culinária e pós-produção de vídeo com IA.

Briefing de produção

Crie uma cena de foley puro de 12 segundos em uma casa de chá de madeira sob a chuva: uma manga de seda roça a mesa, três passos com sapatos de couro se aproximam, uma porta de correr abre e uma xícara de porcelana é colocada na madeira. Sem diálogo ou música.

Áudio gerado

Chuva na casa de chá

0:12
0:00
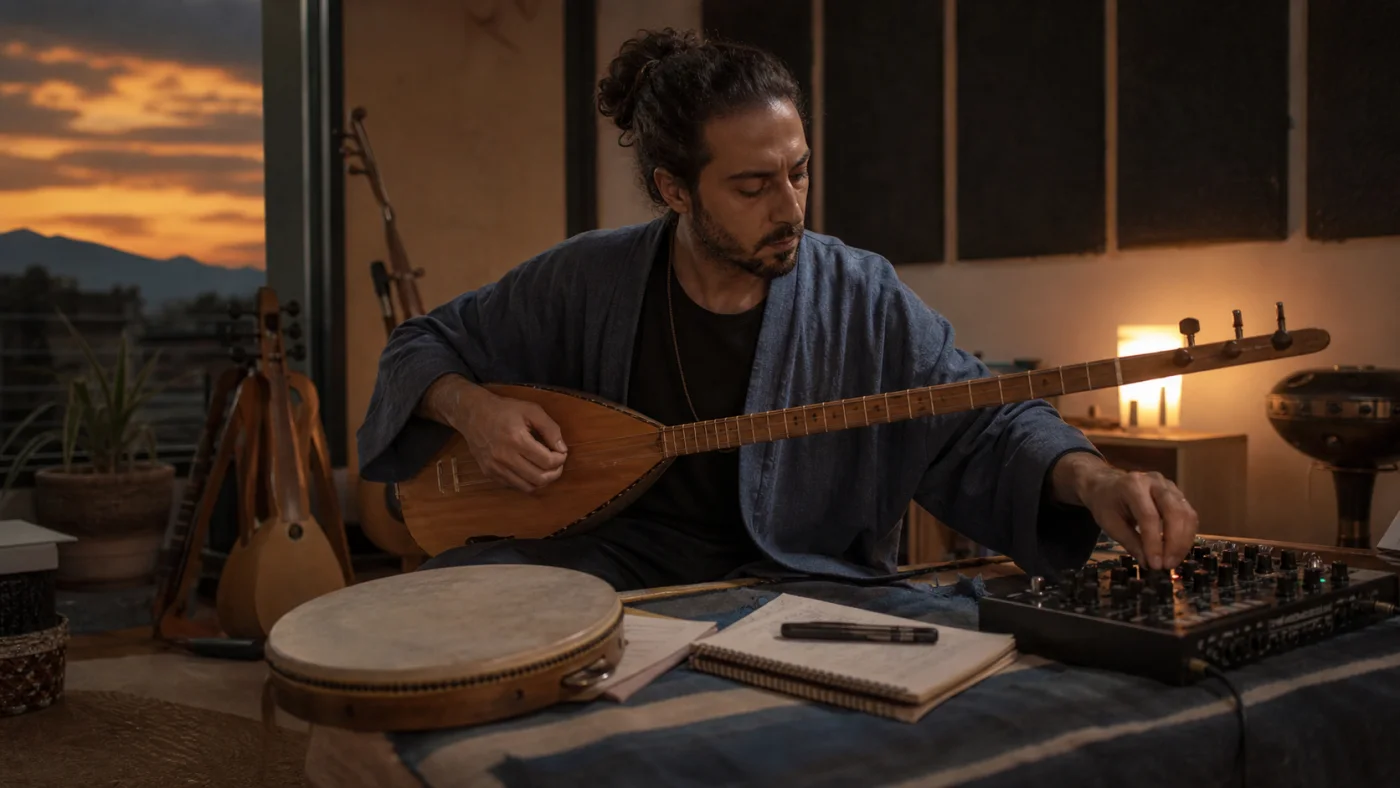
Um compositor criando uma faixa instrumental inspirada na Rota da Seda
02Trilhas sonorasMúsica publicitáriaEstilos regionais

Música com IA

Produza trilhas, refrões e músicas de fundo originais para filmes, anúncios e formatos regionais sem procurar em bibliotecas de estoque.

Briefing de produção

Componha uma faixa cinematográfica para uma viagem noturna pela Rota da Seda com alaúde dedilhado, tambor de moldura e baixo moderno. Chegue a um refrão marcante no oitavo segundo. Apenas instrumental.

Áudio gerado

Rota da Seda ao anoitecer

0:16
0:00
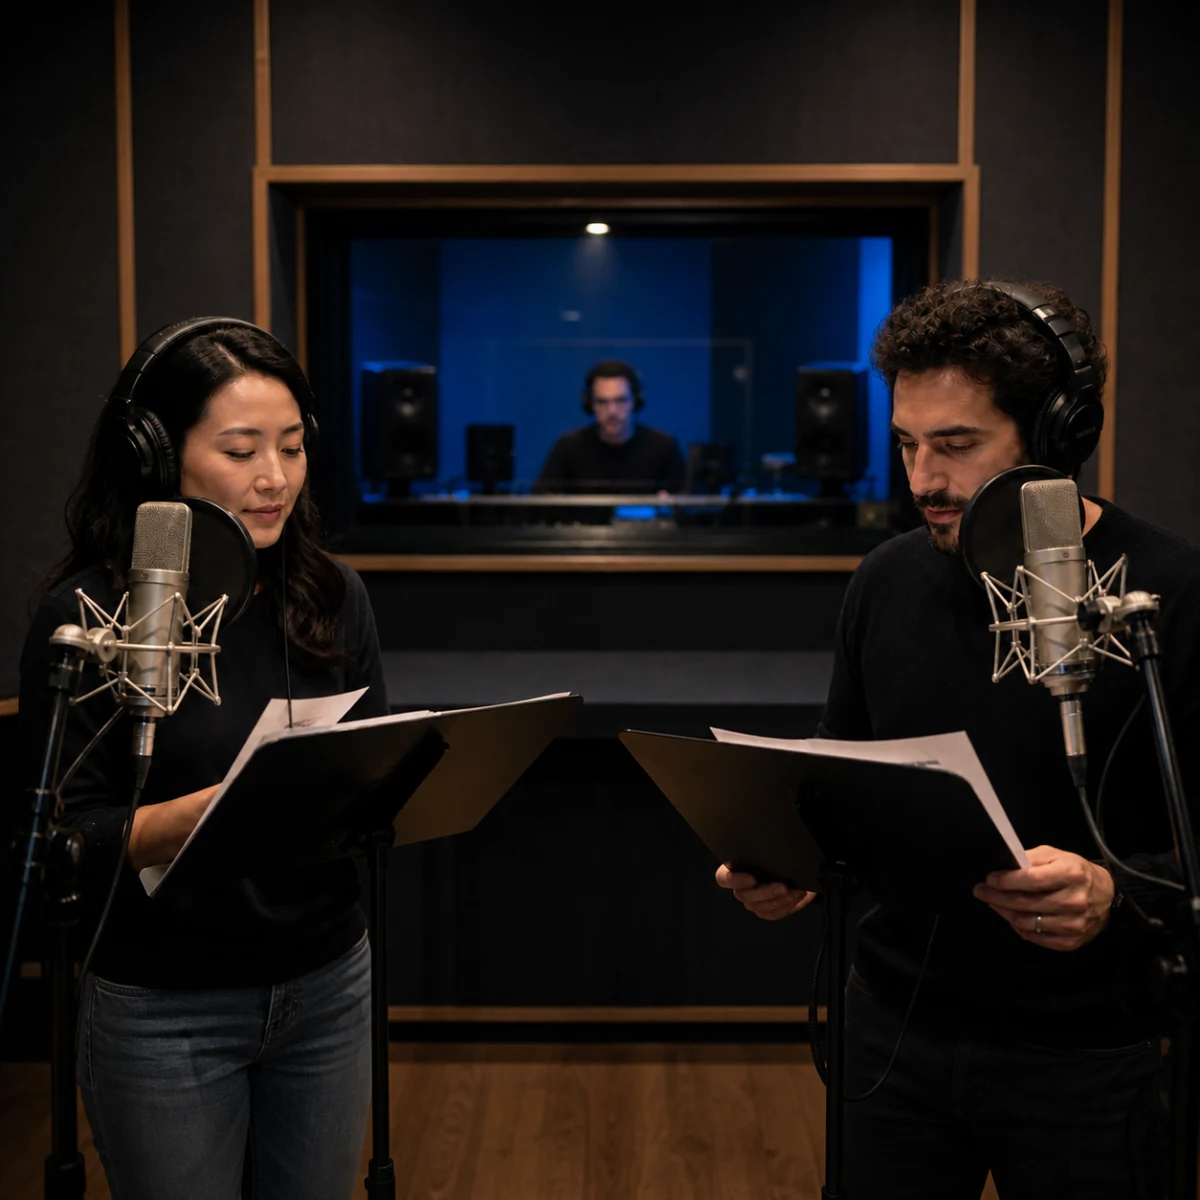
Dois dubladores gravando um diálogo multilíngue em um estúdio
03LocalizaçãoDublagemLocução comercial

TTS e diálogo multilíngue

Localize diálogos, anúncios e narrações com papéis distintos, emoção controlada e interpretação natural, em vez de uma leitura monótona com uma só voz.

Briefing de produção

Em um porto antes do amanhecer, crie a mesma conversa contida entre dois personagens em italiano e chinês. Mantenha a pronúncia natural, uma leve ambiência portuária e nenhuma música.

Versões por idioma

Luz do porto · Italiano

0:14
0:00
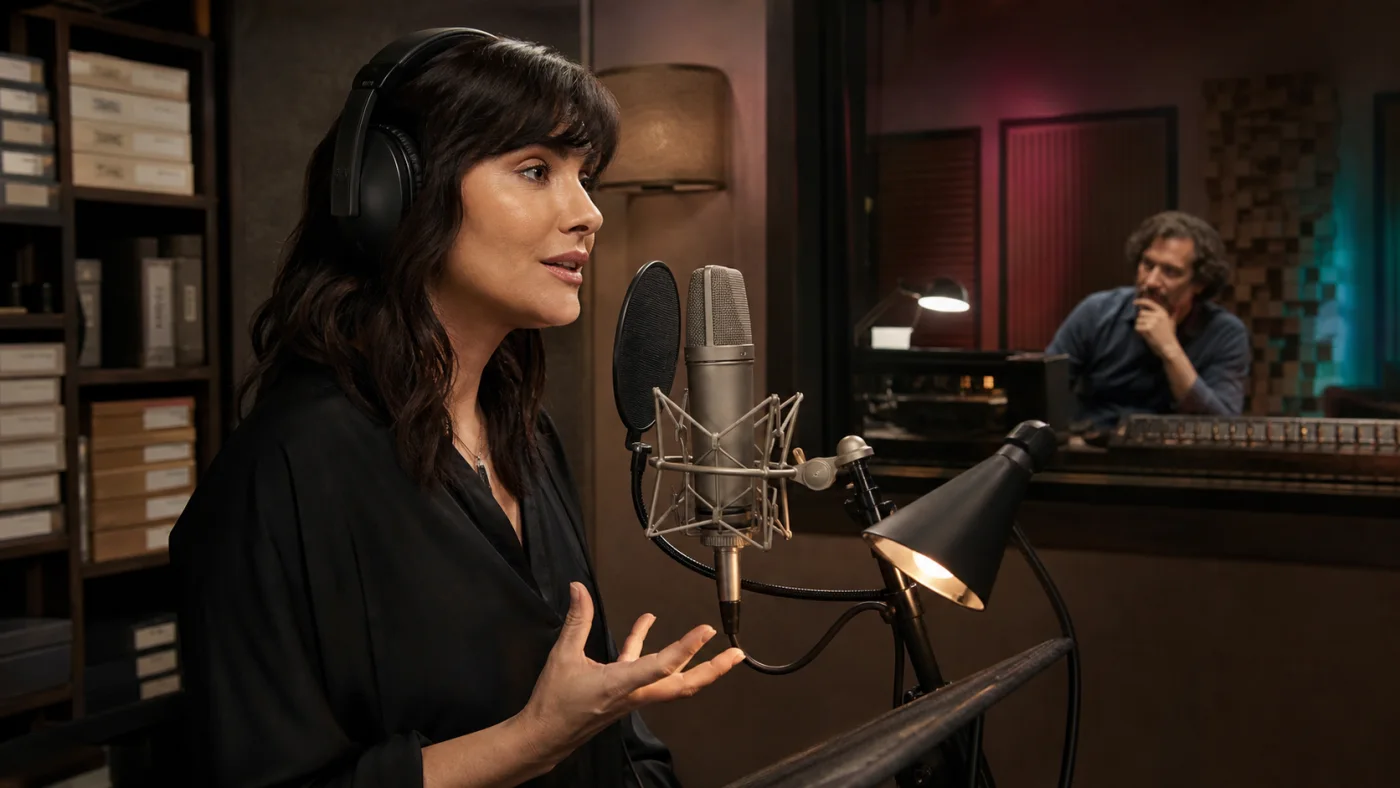
Um narrador autorizado gravando uma biblioteca de voz reutilizável
04Continuidade do personagemVoz da marcaProdução em série

Clonagem de voz

Mantenha uma voz autorizada de personagem ou marca consistente entre episódios, campanhas e mercados enquanto altera o roteiro sob demanda.

Briefing de produção

Use @Audio1 como referência de voz autorizada. Preserve sua identidade acolhedora, ritmo calmo e sotaque suave ao ler: ‘Every new chapter begins with one clear breath.’

Comparação de vozes

Referência autorizada

Hora tranquila · Original

0:09
0:00

Variação gerada

Novo capítulo · Clonada

0:07
0:00
Clone apenas vozes que sejam suas ou para as quais você tenha permissão explícita.

Seed Audio 1.0 vs traditional TTS

How Seed Audio 1.0 differs from traditional text-to-speech

Traditional TTS is designed to turn written text into spoken voice. Seed Audio 1.0 is designed for broader audio generation, combining dialogue, performance direction, ambience, music, and sound effects in one sound-scene workflow.

Feature comparison between Seed Audio 1.0 and traditional text-to-speech systems
CapabilitySeed Audio 1.0Traditional TTS (early commercial TTS and basic speech synthesis)
Core positioningScene-level audio creationText-to-speech
Generated contentSpoken dialogue + background music + sound effects + ambience, generated and mixed in one passVoice only (a single speech track)
Multiple speakersNative support for generating coordinated multi-character dialogue, emotion, and pacing in one passUsually requires repeated calls with different voices, followed by manual alignment and mixing
Background music & sound effectsGenerated with the dialogue and automatically matched to its emotion and timelineNot included; requires separate music models, sound libraries, and a DAW
Input methodText prompt / reference audio (up to 3 clips) / reference imageMainly text + a preset voice; some systems support basic references
Voice cloningZero-shot cloning from a short uploaded reference clip (about 30 seconds or less)Often requires fine-tuning or training, or relies on a limited voice library
Emotion & expressiveness controlDescribe emotion, tone, accent, and pacing directly in natural languagePrimarily controlled through SSML tags or limited parameters, with a narrower expressive range
Timeline controlFine timestamp control over when dialogue appearsGenerally not available
Output formatA fully mixed, non-streaming audio track up to about 2 minutes per generationA single voice file that requires music and sound effects to be added later
Best suited forAudio drama, short-form dubbing, ads, game audio, podcast cold opens, video narration, and other complete sound scenesAudiobook reading, navigation, customer service, simple narration, and other voice-only needs
Workflow changeOne prompt → finished audio track, substantially reducing post-production mixingGenerate speech → find music → find sound effects → align and mix manually

Traditional TTS remains the simpler choice when you only need predictable speech. Choose Seed Audio 1.0 when the surrounding scene and sound design are part of the output.

Fluxo de trabalho simples

Da ideia de cena ao design de som multicamadas.

Vá de uma ideia sonora a uma direção de cena completa: personagens, emoção, local, diálogo, música, ambiente e efeitos em um único prompt.

01

Descreva a cena sonora

Comece com personagens, emoção, local, tempo, diálogo e ambiente musical.

02

Deixe o modelo compor as camadas

Seed Audio 1.0 é projetado para sintetizar diálogos, tom emocional, sotaques, ambiente, BGM e efeitos.

03

Use em todos os formatos criativos

Crie direção sonora para curtas, anúncios, podcasts, jogos e conteúdo educacional.

Tecnologia Seed Audio 1.0

Um modelo de som que vai além da síntese de fala.

Seed Audio 1.0 é projetado para cenas completas: diálogos, emoções, sotaques, ambientes, BGM e Foley.

Multifalante

continuidade de voz para cenas longas

Texto / imagem / áudio

prompt multimodal para criação de áudio

Geração de áudio tudo-em-um

Componha várias camadas de som de uma vez em vez de ferramentas separadas.

Controle de emoções e sotaques

Guie tom, emoção e sotaques mantendo vozes reconhecíveis.

Ambiente de cena e BGM

Gere ambientes, BGM, som de sala, clima e texturas urbanas junto ao diálogo.

Cenas de áudio longas

Seed Audio 1.0 foi projetado para cenas sonoras longas com diálogos, ambientes e sequências musicais.

Possibilidades criativas

Cenas sonoras para vídeo, jogos, educação e publicidade.

Seed Audio 1.0 é ideal quando um projeto precisa mais do que narração.

Design de som para curtas

Esboce diálogos, emoções, Foley, ambiente e música para storyboards.

Criativos de marketing

Crie direção sonora para demonstrações, clipes sociais e anúncios localizados.

Protótipos de jogos e XR

Prototipe loops ambientes, sons de personagens e momentos cinemáticos.

Conteúdo educacional

Crie lições baseadas em cenários com dicas sonoras espaciais.

Diálogo

Voz multipersonagem com tom emocional

Ambiente

Chuva, trânsito, salas, multidões e ambientes naturais

Foley

Passos, impactos, portas, textura e sincronismo

Preços

Escolha o plano Seed Audio 1.0 ideal

Assine para obter o melhor valor ou compre créditos quando precisar de uma recarga flexível.

Ver detalhes de preços do Seed Audio 1.0
Free
US$ 0

Experimente o Seed Audio 1.0 com créditos de cadastro. Ideal para testar prompts e cenas curtas.

  • 10 créditos grátis
  • Até ~8 segundos por geração
  • Até 2 min de áudio por geração
  • Acesso à API
  • Suporte prioritário
Pro
Economize US$ 39,98
US$ 16,66US$ 19,99/mo

A melhor escolha anual para criadores com necessidades regulares.

  • 30.000 créditos por ano
  • Até ~400 minutos de áudio no total
  • Tudo do Free
  • Mais espaço para projetos longos
  • Uploads de voz de referência
  • Suporte prioritário
  • Máx. 2 min por geração
  • Seed Audio 1.0 API access — shared credits
Max
Economize US$ 99,98
US$ 41,66US$ 49,99/mo

O melhor valor para equipes com geração intensiva.

  • 90.000 créditos por ano
  • Até ~1.200 minutos de áudio no total
  • Tudo do Pro
  • Melhor custo-benefício
  • Maior buffer anual
  • Adequado para equipes e agências
  • Máx. 2 min por geração
  • Seed Audio 1.0 API access — shared credits
Dúvidas sobre faturamento, acesso ou necessidades personalizadas?contact@seedaudio.co

Perguntas frequentes

Perguntas frequentes

Respostas práticas para criadores que desejam entender o Seed Audio 1.0.

Crie cenas sonoras mais ricas com Seed Audio 1.0.

Conheça os recursos do modelo, status de acesso e casos de uso práticos.