Seed Audio 1.0
สมัคร
Seed Audio 1.0 เครื่องสร้างเสียง AI

Seed Audio 1.0 เครื่องสร้างเสียง AI

Seed Audio 1.0 คือโมเดลสร้างเสียงแบบครบวงจรจาก ByteDance Seed สำหรับสร้างฉากเสียงที่สมบูรณ์ ใช้ข้อความ รูปภาพ หรือเสียงเพื่อนำทางบทสนทนาหลายผู้พูด การแสดงอารมณ์ สำเนียง บรรยากาศ ดนตรีประกอบ และเอฟเฟกต์แบบ Foley

2 นาที
หน้าต่างสร้างเสียงต่อเซสชัน
หนึ่งพรอมต์
ควบคุมบทสนทนา น้ำเสียง บรรยากาศ BGM และ SFX
มัลติโมดัล
บริบทข้อความ รูปภาพ และเสียงสำหรับฉากเสียง

Seed Audio 1.0

ตัวอย่างพรอมต์ฉาก

การสร้างเสียง
ห้องควบคุมสร้างเสียง AI แบบนามธรรมพร้อมแผงคลื่นเสียงแบบชั้น

แนวคิดพรอมต์

นักพูดสองคนกระซิบในตรอกฝนตก มีสายเครื่องสายตึงเครียดเบื้องหลัง เสียงรถไกล เสียงฝีเท้า และประตูโลหะปิดดังปัง

ลำต้นบทสนทนา
ชั้น BGM
บรรยากาศ + SFX

เริ่มสร้าง Seed Audio 1.0 ออนไลน์

ใช้พื้นที่ทำงาน Seed Audio 1.0 ด้านล่างเพื่อสร้างฉากเสียงจากพรอมต์ เสียงอ้างอิง หรือรูปภาพอ้างอิง

อินพุต

สร้างเสียงด้วยพรอมต์เป็นหลัก พร้อมควบคุมเพิ่มเติม

พรอมต์*
83/2048

การตั้งค่าเพิ่มเติม

ปรับแต่งอินพุตของคุณด้วยการควบคุมเพิ่มเติม

ประวัติ

การสร้าง Seed Audio 1.0 Preview ล่าสุดของคุณ

เข้าสู่ระบบเพื่อดูประวัติการสร้างของคุณ

ภาพรวมโมเดล

Seed Audio 1.0 คืออะไร?

Seed Audio 1.0 คือโมเดลสร้างเสียง AI แบบมัลติโหมดของ ByteDance Seed สำหรับสร้างฉากเสียงที่สมบูรณ์จากข้อความ รูปภาพ และเสียง ภายในเวิร์กโฟลว์เดียว โมเดลสามารถรวมบทสนทนาหลายผู้พูด เสียงที่สื่ออารมณ์ สำเนียงที่เป็นธรรมชาติ บรรยากาศ ดนตรีประกอบ และเอฟเฟกต์เสียงแบบ Foley แทนที่จะสร้างเพียงเสียงพูด

พร้อมท์สามารถอธิบายผู้พูด จังหวะเวลา อารมณ์ ภาษา สถานที่ ทิศทางดนตรี และเหตุการณ์เสียงร่วมกัน เหมาะสำหรับฉากภาพยนตร์ บทสนทนาหลายภาษา โฆษณา พอดแคสต์ เกม และงานที่ต้องให้เสียงพูดกับซาวด์สเคปทำงานเป็นหนึ่งเดียว

เรียนรู้เพิ่มเติมเกี่ยวกับ Seed Audio 1.0

อินพุต

ข้อความ รูปภาพ และเสียงอ้างอิงสูงสุด 3 รายการ

เลเยอร์เสียง

บทสนทนา เสียงพูด บรรยากาศ ดนตรี และเอฟเฟกต์

เอาต์พุต

ฉากเสียงที่ประสานกันยาวสูงสุด 2 นาที

วิธีใช้งาน

วิธีใช้ Seed Audio 1.0 ออนไลน์

หากต้องการใช้ Seed Audio 1.0 ออนไลน์ ให้เขียนพรอมป์ฉากเสียง เพิ่มเสียงหรือรูปภาพอ้างอิงหากต้องการ เลือกการตั้งค่าเอาต์พุต แล้วสร้างและตรวจสอบเสียงในพื้นที่ทำงาน SeedAudio.co

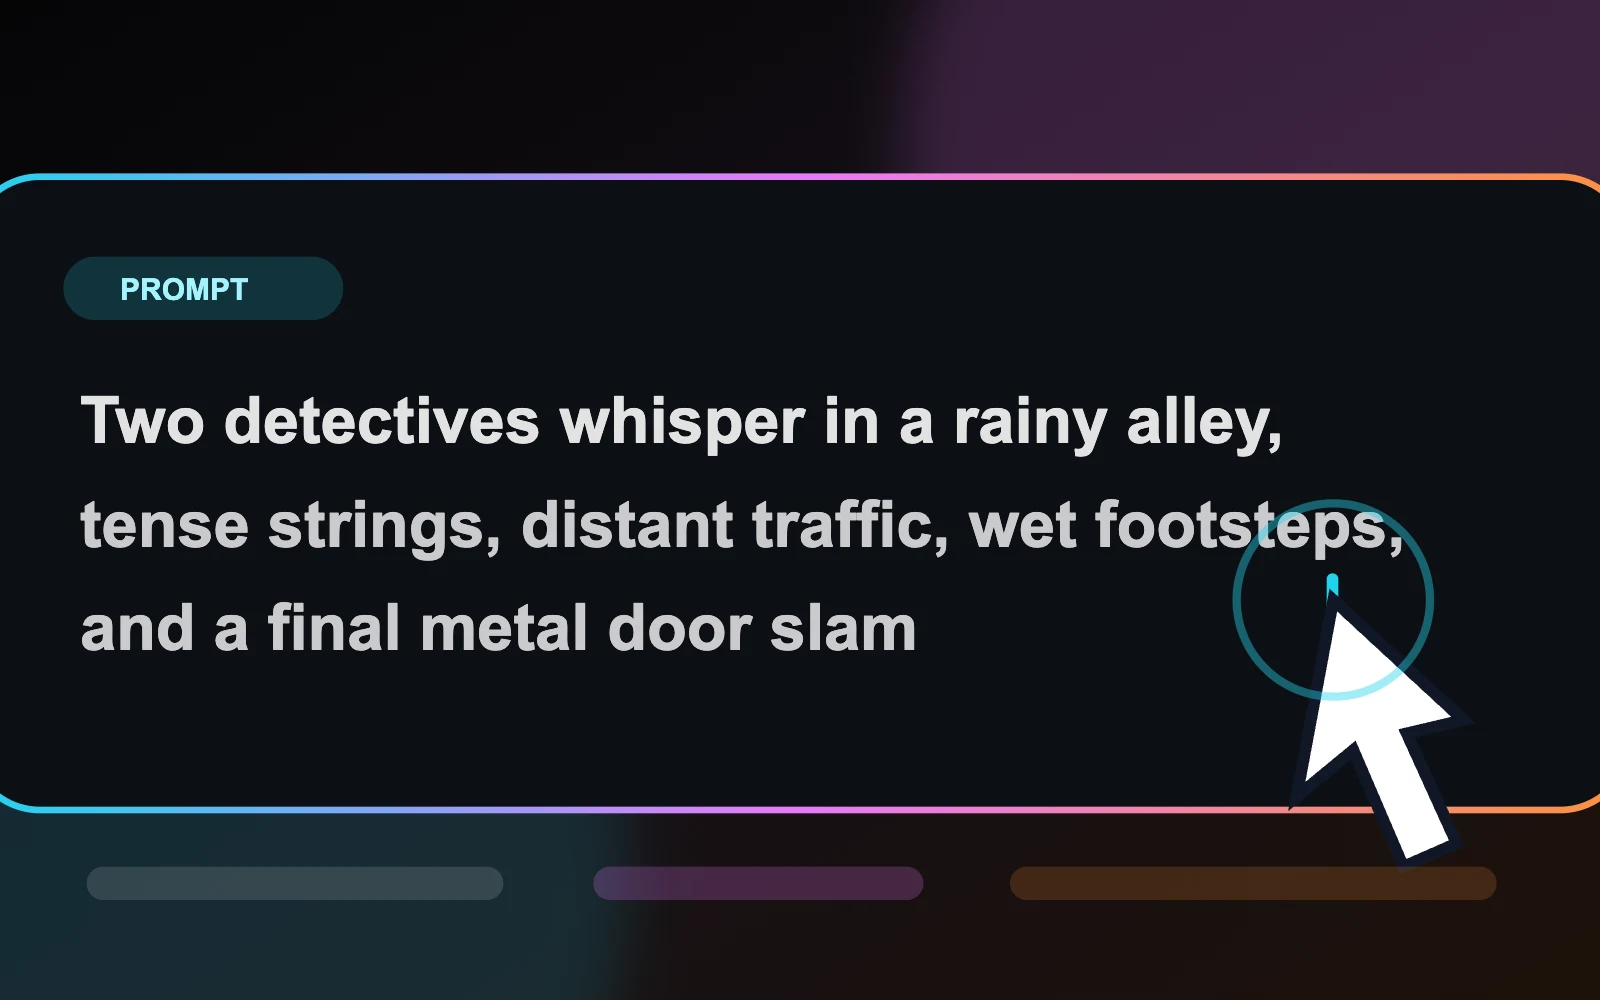
  1. ตัวแก้ไขพรอมป์ Seed Audio 1.0 สำหรับเขียนพรอมป์ฉากเสียงแบบมีโครงสร้าง
    01

    เขียนพรอมป์ฉากเสียง

    อธิบายตัวละคร ภาษา อารมณ์ สถานที่ บทพูด บรรยากาศ ทิศทางดนตรี และเหตุการณ์เสียงที่ต้องการในฉาก

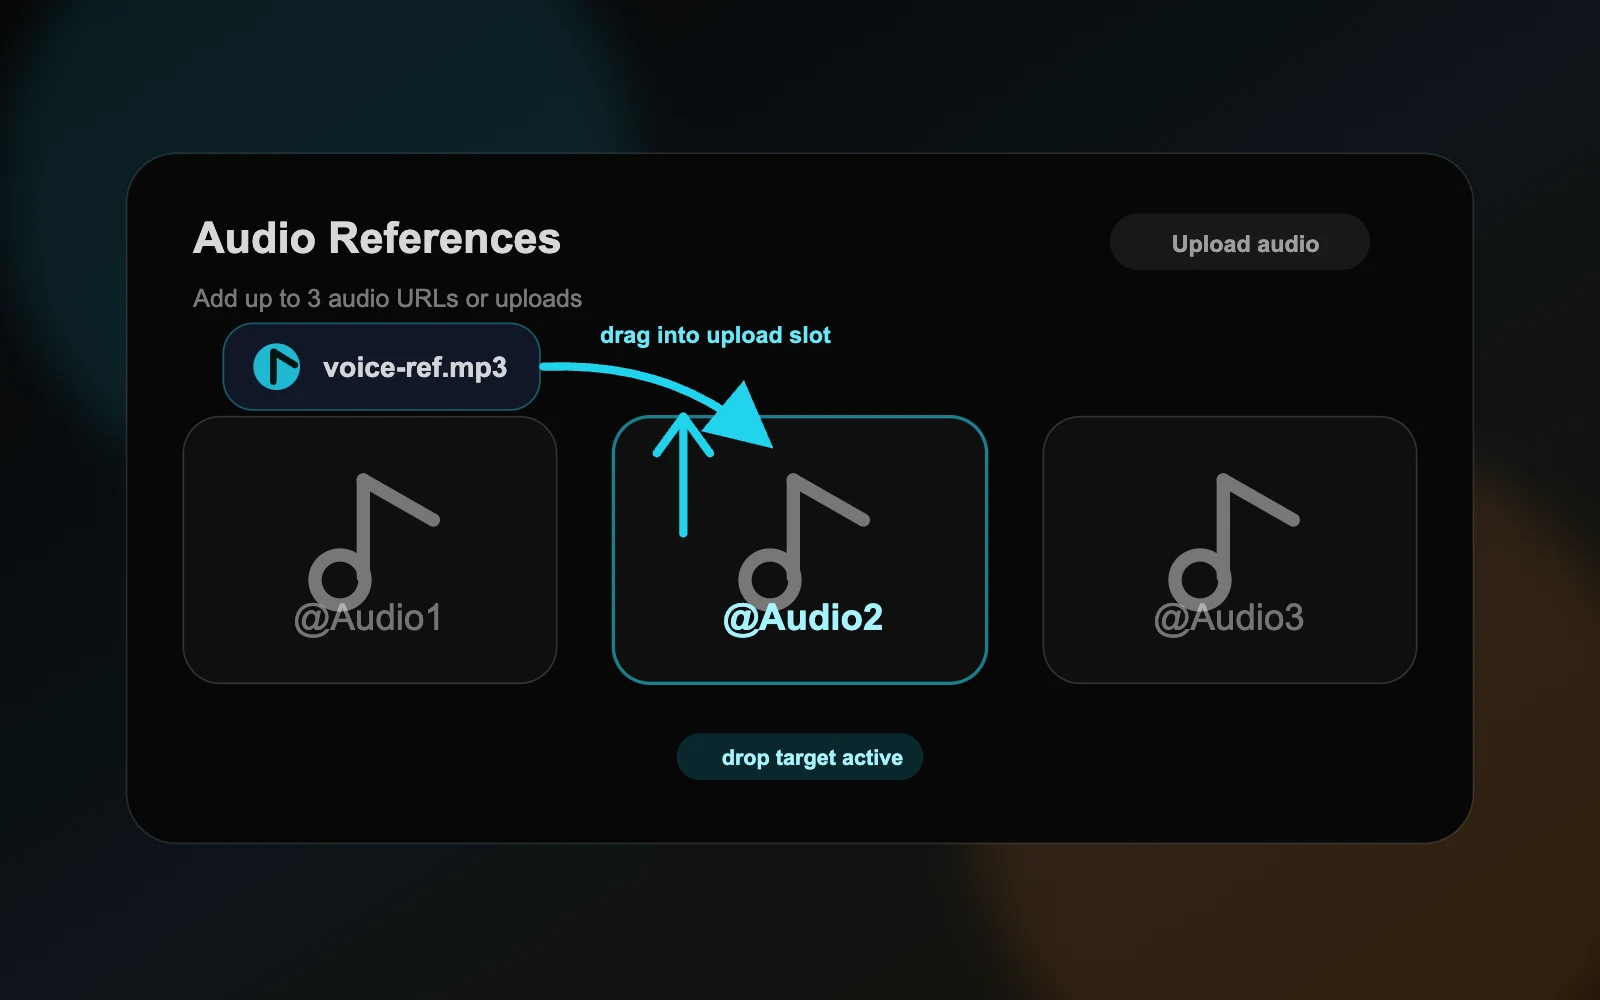
  2. ตัวควบคุม Seed Audio 1.0 สำหรับเพิ่มเสียงอ้างอิงหรือภาพอ้างอิงหนึ่งภาพ
    02

    เพิ่มข้อมูลอ้างอิงเสริม

    ใช้เสียงอ้างอิงได้สูงสุดสามรายการเพื่อกำหนดเสียงหรือสไตล์ หรือใช้ภาพหนึ่งภาพเพื่อสื่ออารมณ์และบริบทของฉาก

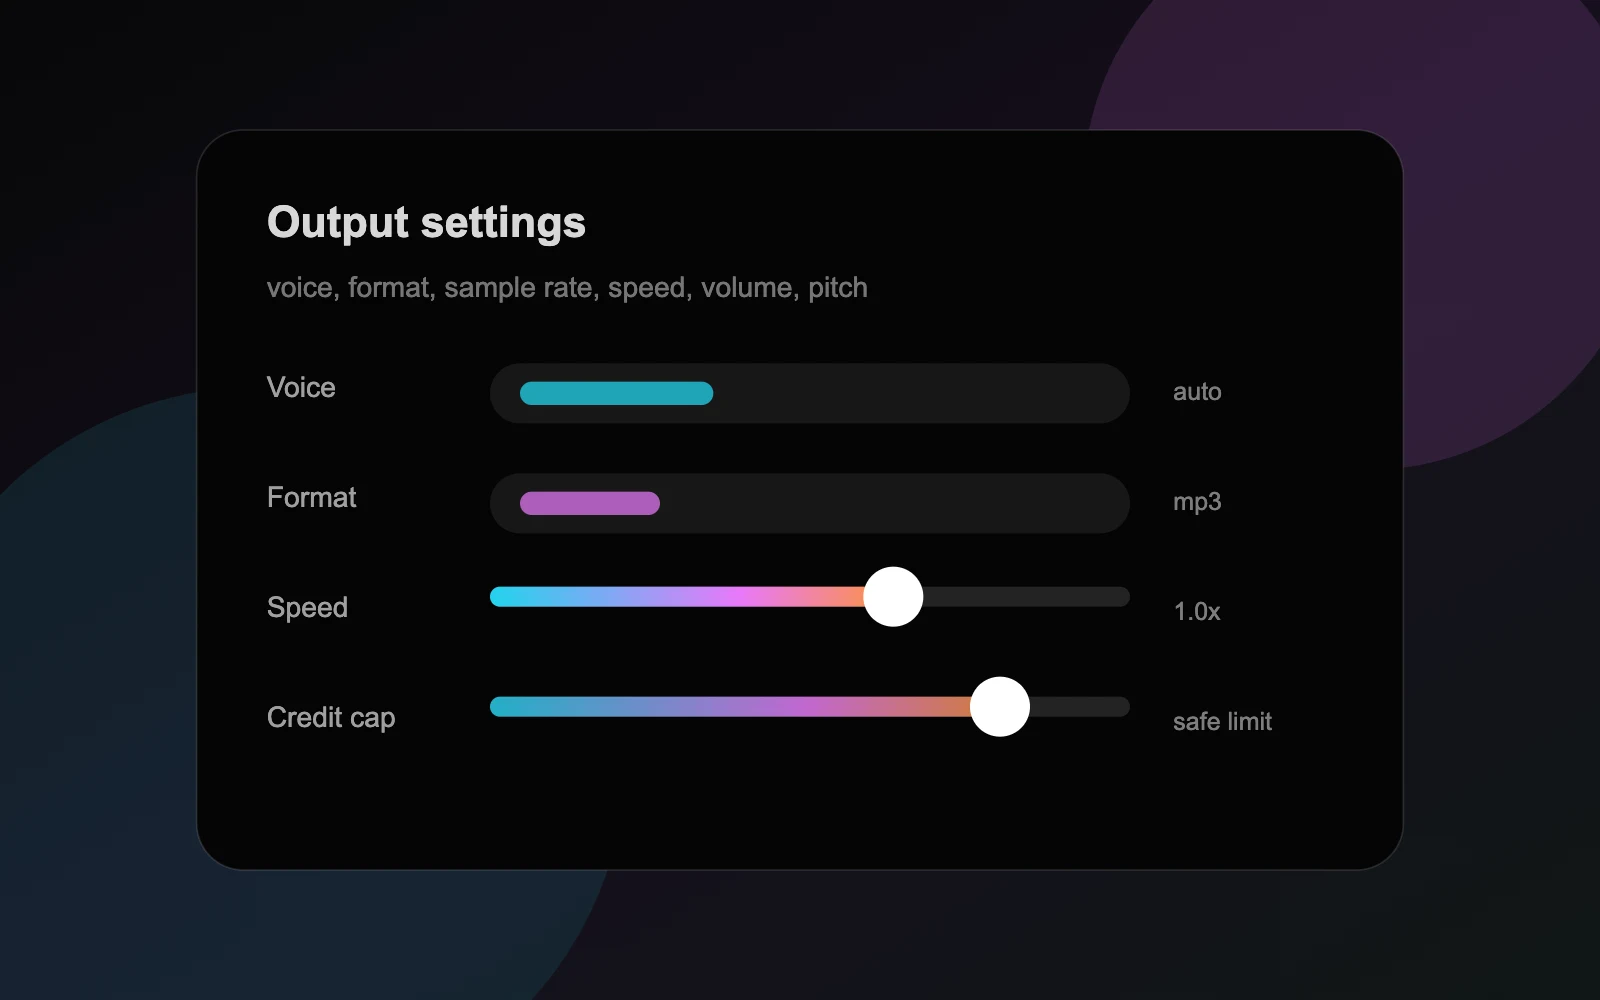
  3. การตั้งค่าเอาต์พุต Seed Audio 1.0 สำหรับเสียง รูปแบบ ความเร็ว ระดับเสียง พิตช์ และเพดานเครดิต
    03

    เลือกการตั้งค่าเอาต์พุต

    เลือกเสียง รูปแบบเอาต์พุต อัตราสุ่มตัวอย่าง ความเร็ว ระดับเสียง พิตช์ และเพดานเครดิตสูงสุดก่อนสร้าง

  4. ผลลัพธ์เสียงที่สร้างด้วย Seed Audio 1.0 พร้อมตัวควบคุมเล่น คัดลอกลิงก์ ดาวน์โหลด และสร้างใหม่
    04

    สร้างและตรวจสอบ

    เริ่มจากดราฟต์สั้น ๆ ฟังความชัดของเสียงพูดและสมดุลของเลเยอร์ จากนั้นคัดลอก ดาวน์โหลด หรือปรับแก้ผลลัพธ์

สูตรพรอมป์

ฉาก + ผู้พูด + อารมณ์ + ภาษา + บรรยากาศ + BGM + เอฟเฟกต์เสียง + เวลา

สร้างมาเพื่อเวิร์กโฟลว์การผลิตจริง

คุณสร้างอะไรได้บ้างด้วย Seed Audio 1.0?

เริ่มจากบรีฟการผลิตเพียงชุดเดียว แล้วสร้างเสียงโฟลีย์ที่ตรงจังหวะ เพลงต้นฉบับ บทสนทนาหลายภาษา และเสียงที่ได้รับอนุญาตซึ่งนำกลับมาใช้ซ้ำได้

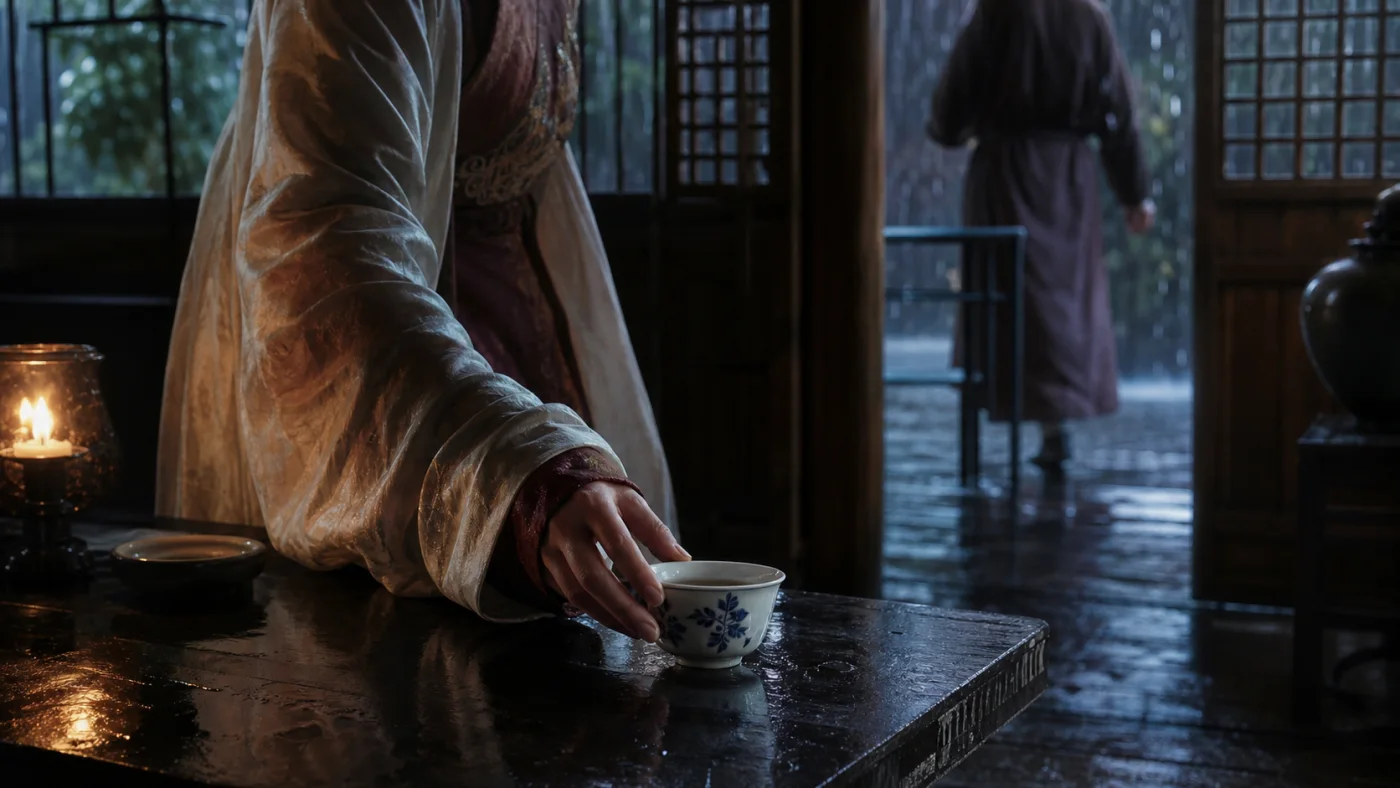
ถ้วยกระเบื้องในโรงน้ำชาเก่าแก่ท่ามกลางสายฝน
01ละครสั้นวิดีโออาหารงานหลังการผลิต AI

เสียงฉากและโฟลีย์

เปลี่ยนช็อตลิสต์ให้เป็นเสียงฝีเท้า เสื้อผ้า อุปกรณ์ประกอบฉาก และบรรยากาศที่พร้อมตัดต่อสำหรับละครสั้น วิดีโออาหาร และงานหลังการผลิตวิดีโอ AI

บรีฟการผลิต

สร้างฉากโฟลีย์ล้วน 12 วินาทีในโรงน้ำชาไม้ท่ามกลางสายฝน: แขนเสื้อไหมเสียดสีกับโต๊ะ เสียงรองเท้าหนังเดินเข้ามาสามก้าว ประตูบานเลื่อนเปิด และถ้วยกระเบื้องวางลงบนโต๊ะไม้ ไม่มีบทสนทนาหรือดนตรี

เสียงที่สร้างขึ้น

สายฝนที่โรงน้ำชา

0:12
0:00
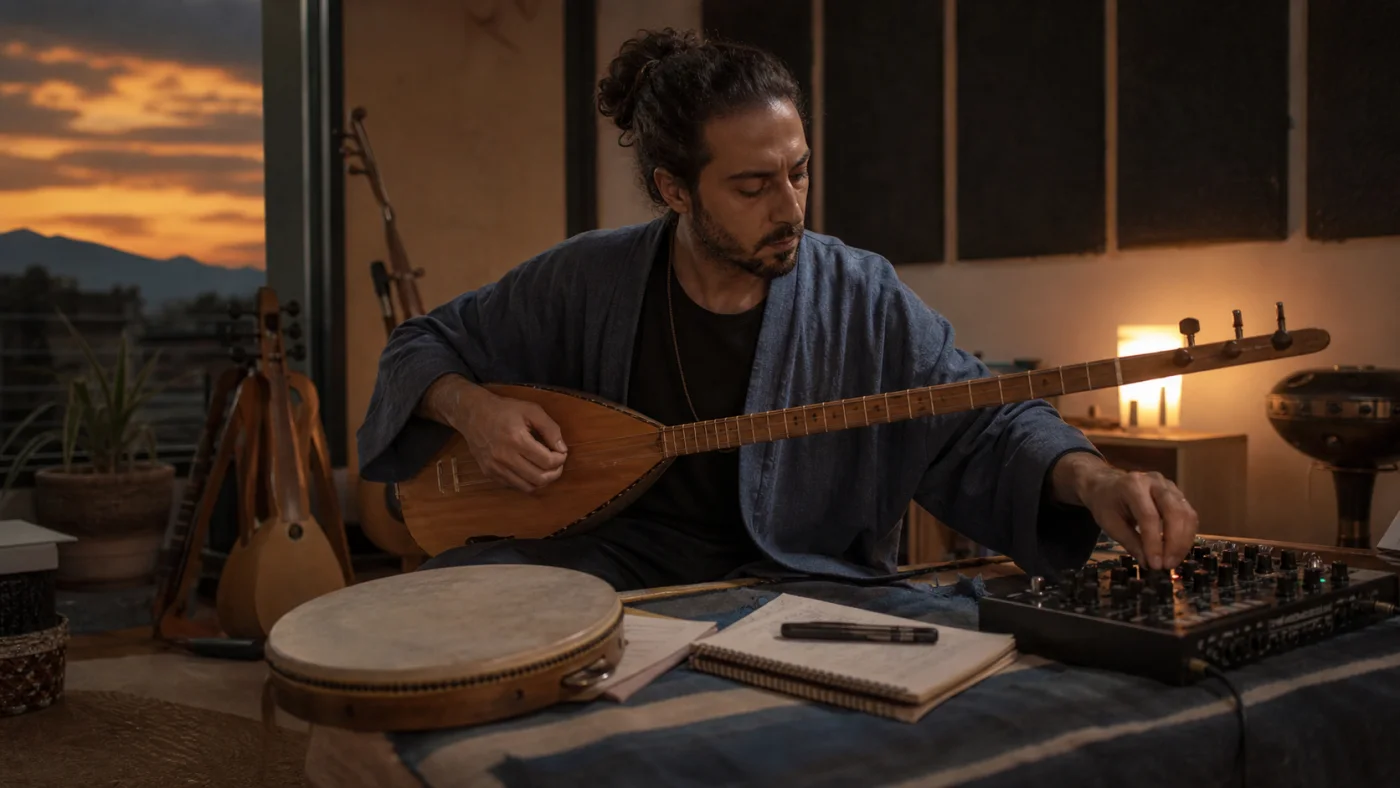
นักแต่งเพลงกำลังสร้างเพลงบรรเลงที่ได้แรงบันดาลใจจากเส้นทางสายไหม
02เพลงประกอบเพลงโฆษณาสไตล์ท้องถิ่น

เพลง AI

สร้างเพลงประกอบ ฮุก และดนตรีพื้นหลังต้นฉบับสำหรับภาพยนตร์ โฆษณา และรูปแบบท้องถิ่น โดยไม่ต้องค้นหาจากคลังเพลงสต็อก

บรีฟการผลิต

แต่งเพลงภาพยนตร์สำหรับการเดินทางยามค่ำคืนบนเส้นทางสายไหม ด้วยเครื่องสายดีด กลองกรอบ และเบสสมัยใหม่ พัฒนาไปสู่ฮุกที่จดจำได้ในวินาทีที่แปด ใช้เฉพาะดนตรีบรรเลง

เสียงที่สร้างขึ้น

เส้นทางสายไหมยามค่ำคืน

0:16
0:00
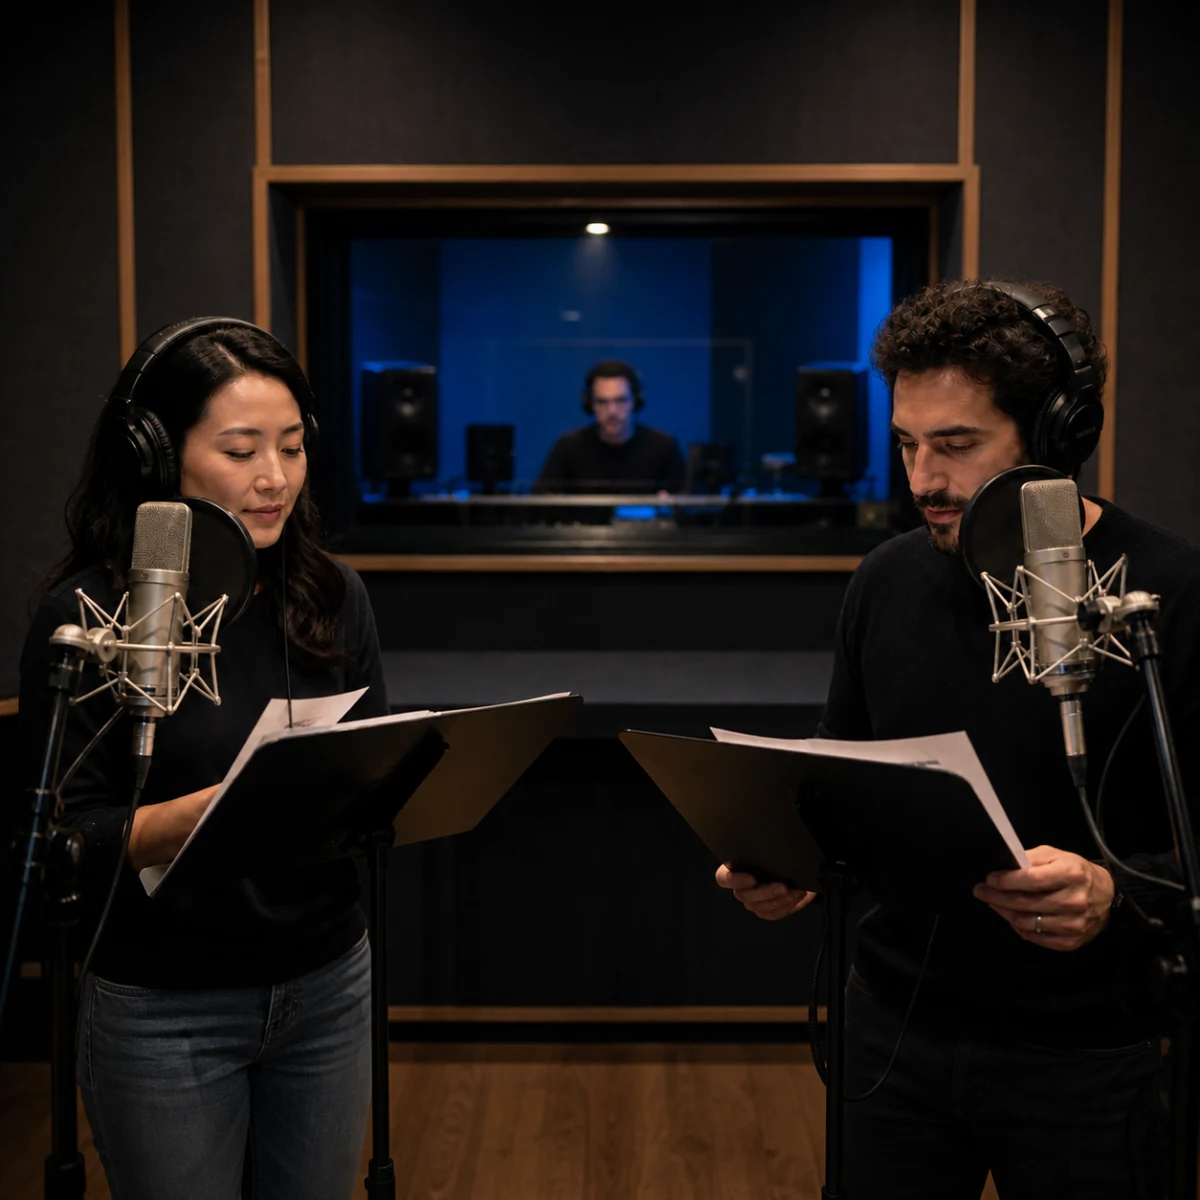
นักพากย์สองคนบันทึกบทสนทนาหลายภาษาในสตูดิโอพากย์เสียง
03การแปลและปรับให้เข้าท้องถิ่นการพากย์เสียงเสียงบรรยายเชิงพาณิชย์

TTS และบทสนทนาหลายภาษา

แปลและพากย์บทสนทนา โฆษณา และเนื้อหาบรรยายด้วยบทบาทที่ชัดเจน การควบคุมอารมณ์ และการถ่ายทอดที่เป็นธรรมชาติ ไม่ใช่การอ่านเสียงเดียวแบบราบเรียบ

บรีฟการผลิต

ที่ท่าเรือก่อนรุ่งสาง สร้างบทสนทนาสองตัวละครที่สุขุมเหมือนกันในภาษาอิตาลีและภาษาจีน รักษาการออกเสียงที่เป็นธรรมชาติ บรรยากาศท่าเรือเบา ๆ และไม่มีดนตรี

เวอร์ชันภาษา

แสงที่ท่าเรือ · ภาษาอิตาลี

0:14
0:00
ผู้บรรยายที่ได้รับอนุญาตกำลังบันทึกคลังเสียงที่นำกลับมาใช้ซ้ำได้
04ความต่อเนื่องของตัวละครเสียงแบรนด์การผลิตแบบซีรีส์

การโคลนเสียง

รักษาเสียงตัวละครหรือเสียงแบรนด์ที่ได้รับอนุญาตให้สม่ำเสมอในทุกตอน แคมเปญ และตลาด พร้อมเปลี่ยนบทได้ตามต้องการ

บรีฟการผลิต

ใช้ @Audio1 เป็นเสียงอ้างอิงที่ได้รับอนุญาต รักษาเอกลักษณ์เสียงที่อบอุ่น จังหวะที่สุขุม และสำเนียงที่นุ่มนวลขณะอ่านว่า: ‘Every new chapter begins with one clear breath.’

เปรียบเทียบเสียง

เสียงอ้างอิงที่ได้รับอนุญาต

ช่วงเวลาเงียบสงบ · ต้นฉบับ

0:09
0:00

เวอร์ชันที่สร้างขึ้น

บทต่อไป · เสียงโคลน

0:07
0:00
โคลนเฉพาะเสียงที่คุณเป็นเจ้าของหรือได้รับอนุญาตอย่างชัดเจนให้ใช้งานเท่านั้น

Seed Audio 1.0 vs traditional TTS

How Seed Audio 1.0 differs from traditional text-to-speech

Traditional TTS is designed to turn written text into spoken voice. Seed Audio 1.0 is designed for broader audio generation, combining dialogue, performance direction, ambience, music, and sound effects in one sound-scene workflow.

Feature comparison between Seed Audio 1.0 and traditional text-to-speech systems
CapabilitySeed Audio 1.0Traditional TTS (early commercial TTS and basic speech synthesis)
Core positioningScene-level audio creationText-to-speech
Generated contentSpoken dialogue + background music + sound effects + ambience, generated and mixed in one passVoice only (a single speech track)
Multiple speakersNative support for generating coordinated multi-character dialogue, emotion, and pacing in one passUsually requires repeated calls with different voices, followed by manual alignment and mixing
Background music & sound effectsGenerated with the dialogue and automatically matched to its emotion and timelineNot included; requires separate music models, sound libraries, and a DAW
Input methodText prompt / reference audio (up to 3 clips) / reference imageMainly text + a preset voice; some systems support basic references
Voice cloningZero-shot cloning from a short uploaded reference clip (about 30 seconds or less)Often requires fine-tuning or training, or relies on a limited voice library
Emotion & expressiveness controlDescribe emotion, tone, accent, and pacing directly in natural languagePrimarily controlled through SSML tags or limited parameters, with a narrower expressive range
Timeline controlFine timestamp control over when dialogue appearsGenerally not available
Output formatA fully mixed, non-streaming audio track up to about 2 minutes per generationA single voice file that requires music and sound effects to be added later
Best suited forAudio drama, short-form dubbing, ads, game audio, podcast cold opens, video narration, and other complete sound scenesAudiobook reading, navigation, customer service, simple narration, and other voice-only needs
Workflow changeOne prompt → finished audio track, substantially reducing post-production mixingGenerate speech → find music → find sound effects → align and mix manually

Traditional TTS remains the simpler choice when you only need predictable speech. Choose Seed Audio 1.0 when the surrounding scene and sound design are part of the output.

เวิร์กโฟลว์ตรงไปตรงมา

จากแนวคิดฉากสู่การออกแบบเสียงแบบหลายชั้น

เปลี่ยนจากแนวคิดเสียงไปเป็นทิศทางฉากที่สมบูรณ์: ตัวละคร อารมณ์ สถานที่ บทสนทนา ดนตรี บรรยากาศ และเอฟเฟกต์ในพรอมต์เดียว

01

อธิบายฉากเสียง

เริ่มต้นด้วยตัวละคร อารมณ์ สถานที่ จังหวะเวลา บทสนทนา อารมณ์ดนตรี และเอฟเฟกต์ที่ควรมีในฉาก

02

ให้โมเดลประกอบเลเยอร์

Seed Audio 1.0 ถูกออกแบบมาเพื่อสังเคราะห์บทสนทนา น้ำเสียงอารมณ์ สำเนียงท้องถิ่น บรรยากาศ BGM และเอฟเฟกต์เสียง

03

ใช้ในรูปแบบสร้างสรรค์ที่หลากหลาย

สร้างทิศทางเสียงสำหรับหนังสั้น โฆษณา พอดแคสต์ เกม เนื้อหาเรียนรู้ และโปรเจกต์อื่น ๆ

เทคโนโลยี Seed Audio 1.0

โมเดลเสียงที่อยู่นอกเหนือการแปลงข้อความเป็นเสียงพูดทั่วไป

Seed Audio 1.0 ถูกวางตำแหน่งสำหรับฉากเสียงที่สมบูรณ์: บทสนทนาหลายตัวละคร อารมณ์ น้ำเสียง สำเนียง บรรยากาศ BGM และ Foley ในครั้งเดียว

หลายผู้พูด

ความต่อเนื่องของเสียงสำหรับฉากยาว

ข้อความ / รูปภาพ / เสียง

พรอมต์มัลติโมดัลสำหรับการสร้างเสียง

สร้างเสียงแบบครบวงจร

ประกอบเลเยอร์เสียงหลายชั้นพร้อมกันแทนที่จะเย็บเสียง ดนตรี บรรยากาศ และเอฟเฟกต์ในเครื่องมือแยกกัน

ควบคุมอารมณ์และสำเนียง

นำทางน้ำเสียง การแสดงอารมณ์ ภาษาถิ่น และสำเนียงธรรมชาติในขณะที่รักษาเสียงที่จำได้

บรรยากาศฉากและ BGM

สร้างสภาพแวดล้อม BGM เสียงห้อง อากาศ ฝูงชน หรือพื้นผิวเมืองไกล ๆ ควบคู่ไปกับบทสนทนา

ฉากเสียงยาว

Seed Audio 1.0 สร้างขึ้นสำหรับฉากเสียงยาว รวมถึงการสร้างแบบเซสชันสำหรับบทสนทนา บรรยากาศ และลำดับดนตรี

ความเป็นไปได้ที่สร้างสรรค์

ฉากเสียงสำหรับวิดีโอ เกม การศึกษา และโฆษณา

Seed Audio 1.0 น่าสนใจที่สุดเมื่อโปรเจกต์ต้องการมากกว่าการบรรยาย: ฉากเสียงที่สมบูรณ์

ออกแบบเสียงหนังสั้น

ร่างบทสนทนา จังหวะอารมณ์ Foley บรรยากาศ และดนตรีสำหรับสตอรีบอร์ด

ครีเอทีฟการตลาด

สร้างทิศทางเสียงพร้อมแคมเปญสำหรับตัวอย่างผลิตภัณฑ์ คลิปโซเชียล และโฆษณาท้องถิ่น

โปรโตไทป์เกมและ XR

สร้างโปรโตไทป์ลูปบรรยากาศ เสียงตัวละคร เสียง UI และช่วงเวลาที่เหมือนภาพยนตร์

เนื้อหาเรียนรู้

สร้างบทเรียนตามสถานการณ์ บทสนทนาตัวละคร และคำอธิบายที่ดื่มด่ำพร้อมสัญญาณเสียงเชิงพื้นที่

บทสนทนา

การส่งเสียงหลายตัวละครด้วยน้ำเสียงอารมณ์

บรรยากาศ

ฝน การจราจร ห้อง ฝูงชน และสภาพแวดล้อมธรรมชาติ

Foley

เสียงฝีเท้า การกระแทก ประตู พื้นผิว และจังหวะเวลา

ราคา

เลือกแผน Seed Audio 1.0 ที่ใช่สำหรับคุณ

สมัครสมาชิกเพื่อความคุ้มค่าที่สุด หรือซื้อเครดิตเมื่อคุณต้องการเติมเงินแบบยืดหยุ่น

ดูรายละเอียดราคา Seed Audio 1.0
Free
US$0

ทดลอง Seed Audio 1.0 ด้วยเครดิตสมัครสมาชิก เหมาะสำหรับทดสอบพรอมต์และฉากสั้น

  • 10 เครดิตฟรี
  • สูงสุด ~8 วินาทีต่อการสร้าง
  • สูงสุด 2 นาทีต่อการสร้าง
  • การเข้าถึง API
  • การสนับสนุนแบบลำดับความสำคัญ
Pro
ประหยัด US$39.98
US$16.66US$19.99/mo

ตัวเลือกรายปีที่ดีที่สุดสำหรับผู้สร้างที่มีความต้องการเสียงต่อเนื่อง

  • 30,000 เครดิตต่อปี
  • สูงสุดประมาณ 400 นาทีเสียงรวม
  • รวมทุกอย่างใน Free
  • พื้นที่มากขึ้นสำหรับโปรเจกต์เสียงยาว
  • อัปโหลดเสียงอ้างอิง
  • สนับสนุนลำดับความสำคัญสูง
  • สูงสุด 2 นาทีต่อการสร้าง
  • Seed Audio 1.0 API access — shared credits
Max
ประหยัด US$99.98
US$41.66US$49.99/mo

คุ้มค่าที่สุดสำหรับทีมที่คาดหวังการสร้างเสียงหนัก

  • 90,000 เครดิตต่อปี
  • สูงสุดประมาณ 1,200 นาทีเสียงรวม
  • ทุกอย่างในโปร
  • คุ้มค่าที่สุดสำหรับการผลิตปริมาณมาก
  • บัฟเฟอร์การผลิตรายปีใหญ่ขึ้น
  • เหมาะสำหรับทีมและเอเจนซี
  • สูงสุด 2 นาทีต่อการสร้าง
  • Seed Audio 1.0 API access — shared credits
คำถามเกี่ยวกับการเรียกเก็บเงิน การเข้าถึง หรือความต้องการแบบกำหนดเอง?contact@seedaudio.co

คำถามที่พบบ่อย

คำถามที่พบบ่อย

คำตอบเชิงปฏิบัติสำหรับผู้สร้างที่ต้องการทำความเข้าใจ Seed Audio 1.0

สร้างฉากเสียงที่สมบูรณ์ยิ่งขึ้นด้วย Seed Audio 1.0

ติดตามความสามารถของโมเดล สถานะการเข้าถึง และกรณีการใช้งานจริง