01短劇後製美食影片AI 影片
場景音效與擬音
把分鏡需求直接變成可放入時間軸的腳步、衣料、道具與環境聲,適用於短劇、美食影片和 AI 影片後製。
製作需求
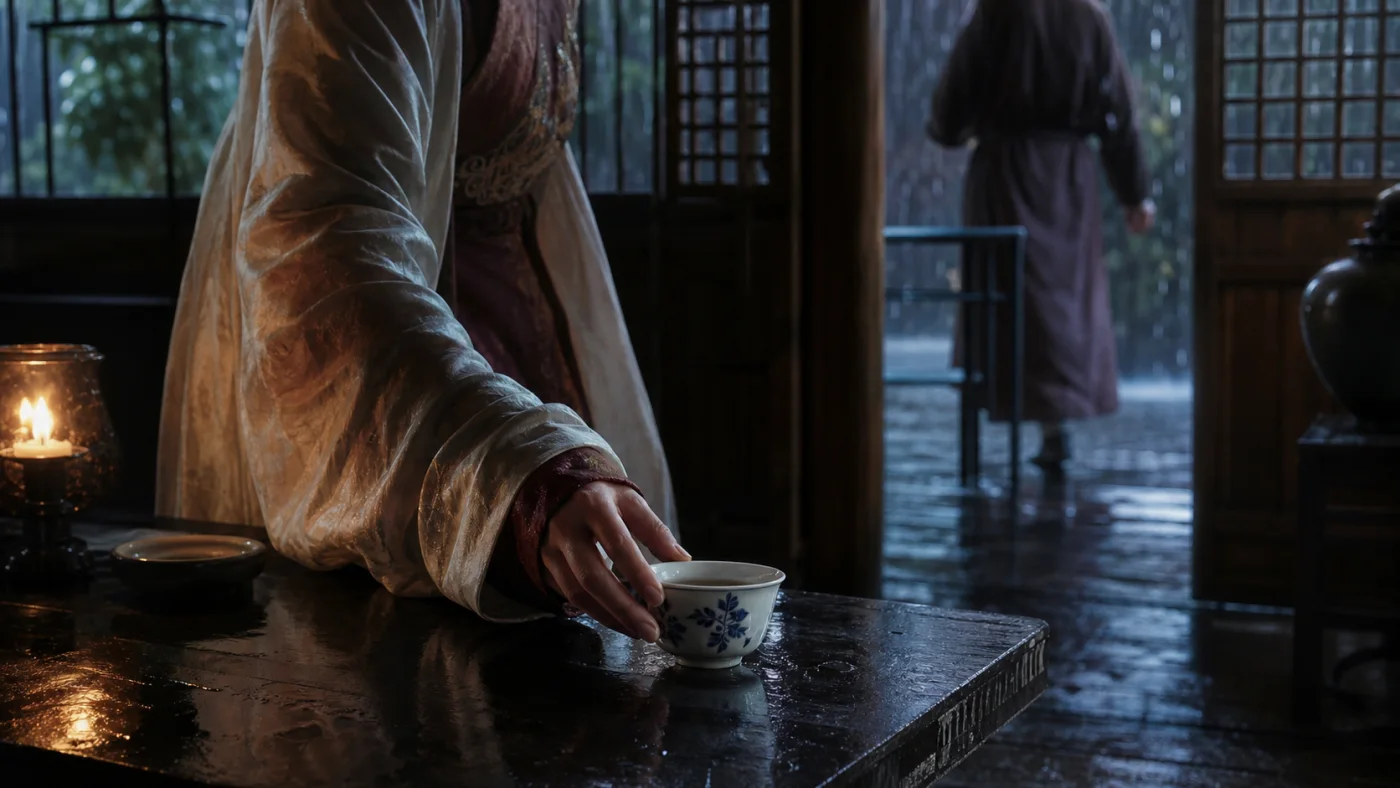
生成 12 秒純擬音:雨夜木造茶館,絲袖擦過桌面,三步皮靴靠近,木門滑開,最後瓷杯落在木桌上。不要對白和音樂。
生成音訊
雨夜茶館
0:120:00
Seed Audio 1.0 是位元組 Seed 的一體化音訊生成模型,面向完整聲音場景創作。你可以用文本、影像或音訊上下文引導多角色對白、情緒表達、原生口音、環境聲、背景音樂與擬音音效。
Seed Audio 1.0
聲音場景 Prompt 預覽
Prompt 概念
兩個角色在雨夜巷口低聲交談,底部有緊張絃樂,遠處車流、腳步聲,最後一聲金屬門撞擊。
使用下方 Seed Audio 1.0 工作區,通過提示詞、可選參考音訊或一張參考影像生成聲音場景。
輸入
以提示詞為核心,可選更多生成控制。
更多設定
展開後可調整更多輸入控制。
歷史記錄
你的 Seed Audio 1.0 Preview 最近生成記錄。
登入後可檢視生成歷史。
模型概覽
Seed Audio 1.0 是 ByteDance Seed 團隊推出的多模態 AI 音訊生成模型,可根據文字、圖片和音訊輸入建立完整聲音場景。它不只把文字轉為語音,還能在同一工作流程中整合多角色對話、富有表情的人聲、自然口音、環境聲、背景音樂和擬音音效。
提示詞可以同時描述說話者、時間節點、情緒、語言、地點、音樂方向和聲音事件,適合電影化場景、多語言對話、廣告、Podcast、遊戲,以及其他需要讓人聲與周圍聲景協同運作的專案。
深入了解 Seed Audio 1.0輸入
文字、圖片,以及最多 3 段參考音訊
聲音層
對話、人聲、環境聲、音樂與音效
輸出
最長 2 分鐘的完整聲音場景
使用方法
在線上使用 Seed Audio 1.0 時,先寫清聲音場景提示詞,視需要加入音訊或圖片參考,選擇輸出設定,然後在 SeedAudio.co 工作區生成並檢查音訊結果。
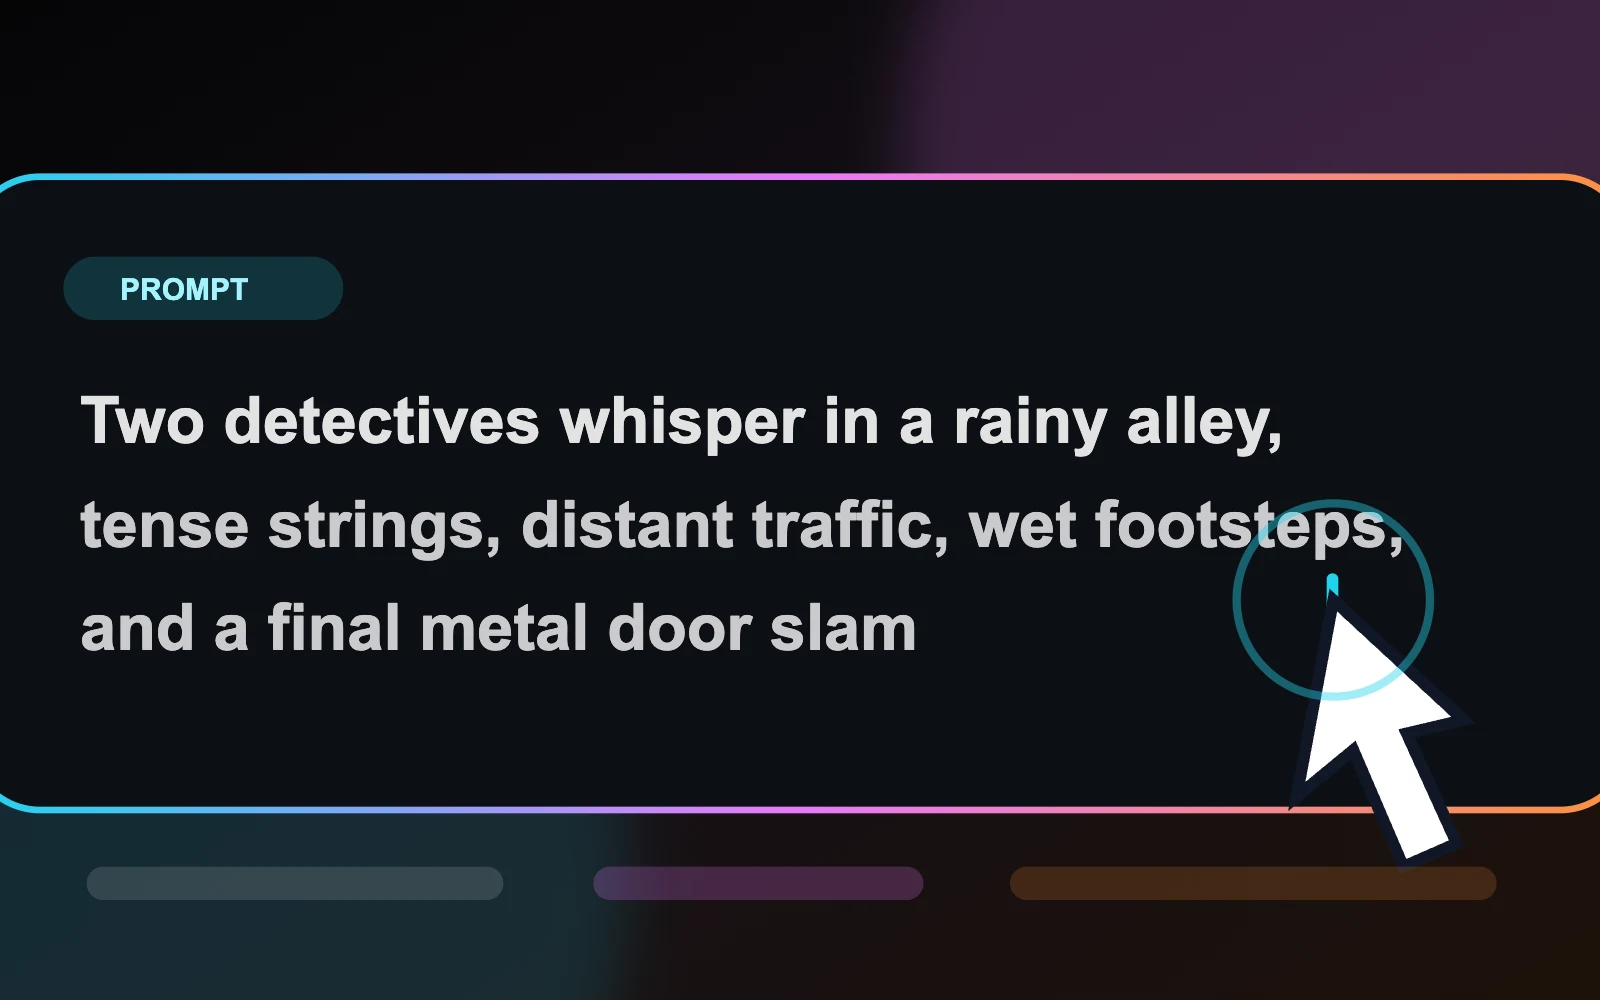
描述角色、語言、情緒、地點、對白、環境聲、音樂方向,以及你希望出現的聲音事件。
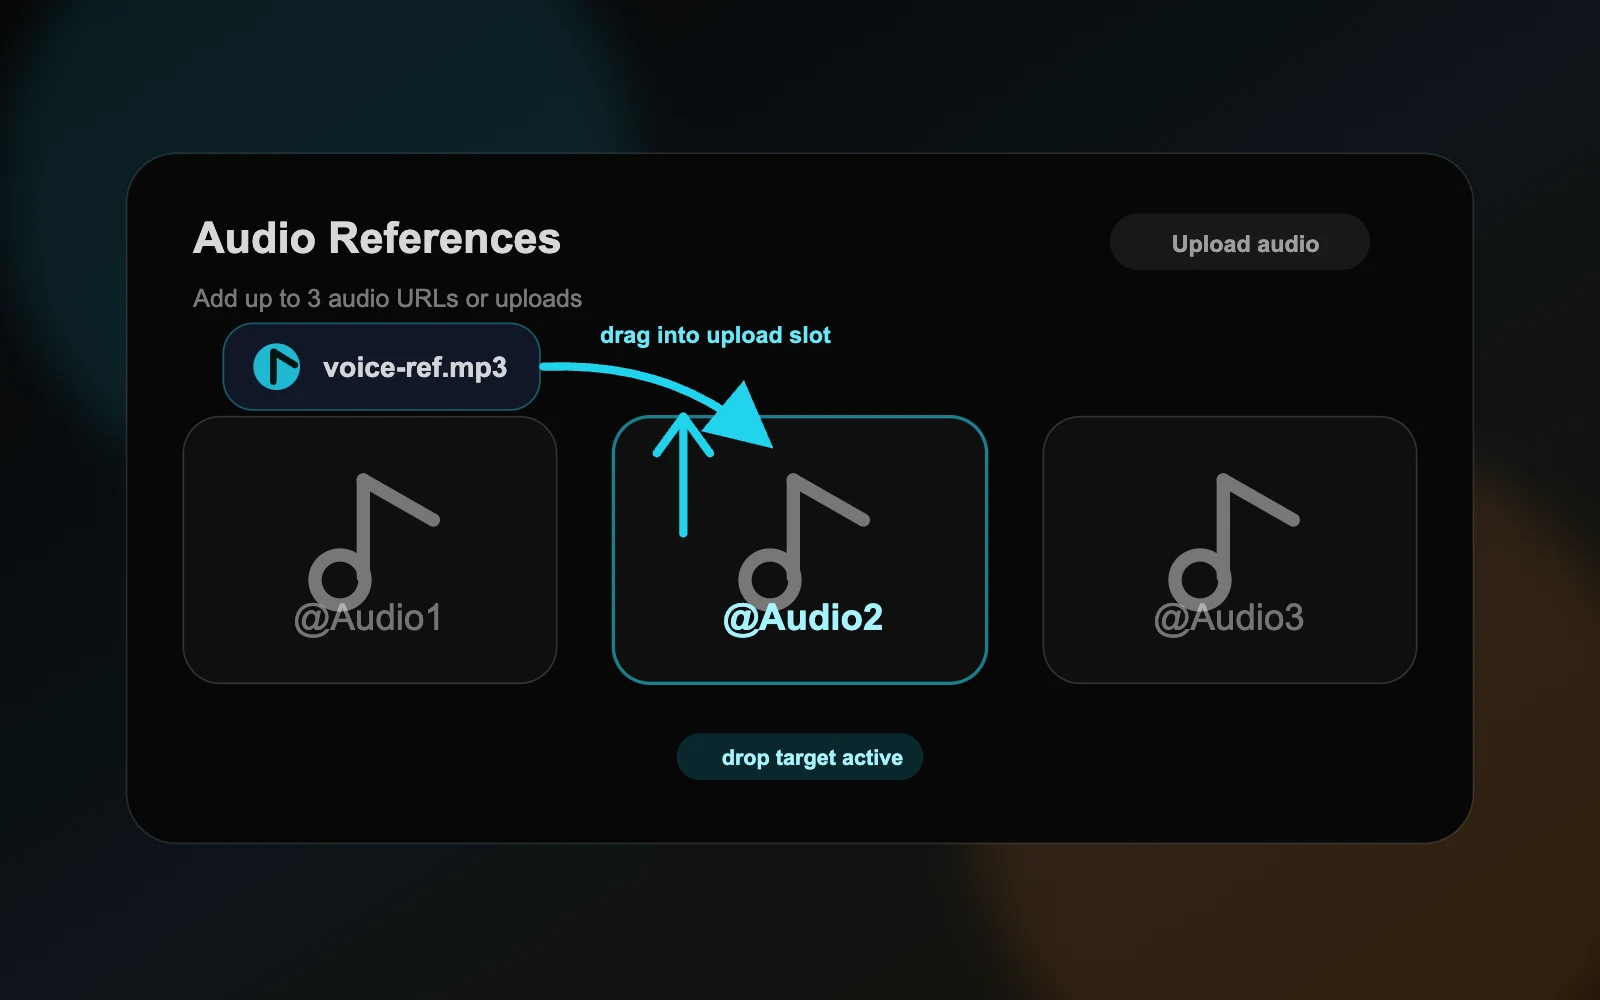
可以用最多 3 段音訊參考引導聲音或風格,也可以用 1 張圖片參考引導情緒和場景上下文。
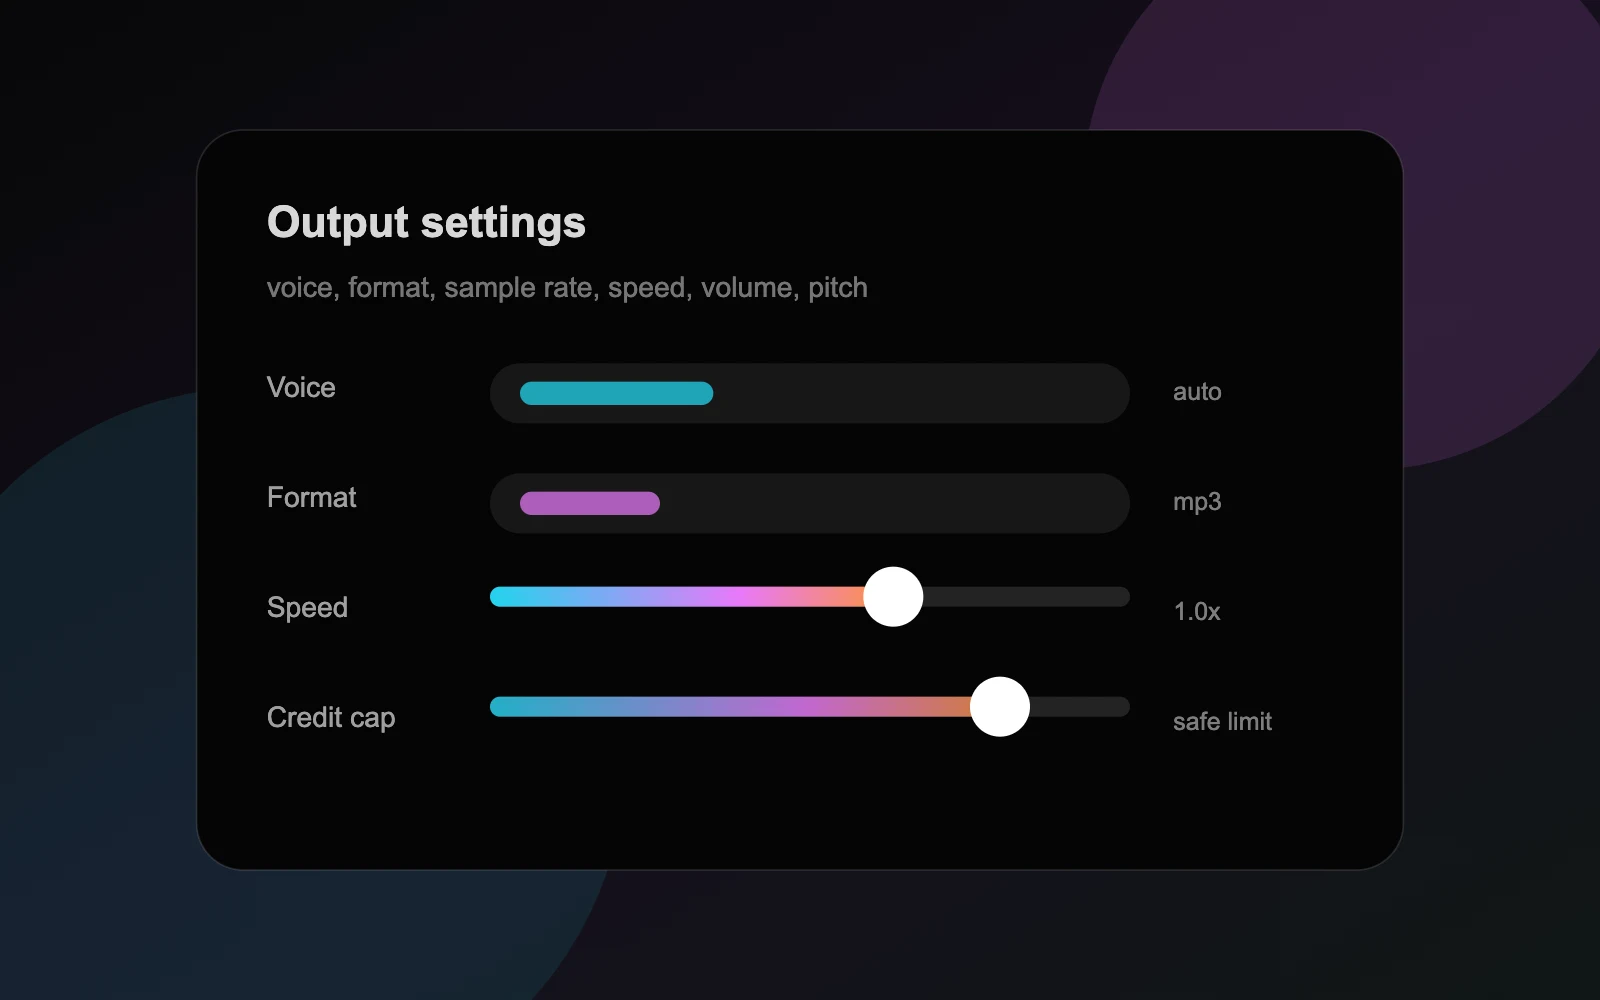
生成前選擇聲音、輸出格式、取樣率、速度、音量、音高和最大 credits 上限。
先生成一段短草稿,檢查人聲清晰度和各聲音層的平衡,再複製、下載或繼續修改結果。
提示詞公式
場景 + 說話者 + 情緒 + 語言 + 環境聲 + BGM + 音效 + 時間點。
面向真實內容製作
從一段製作需求出發,生成精準卡點的擬音、原創音樂、多語言對白與可重複使用的授權聲線。
把分鏡需求直接變成可放入時間軸的腳步、衣料、道具與環境聲,適用於短劇、美食影片和 AI 影片後製。
生成 12 秒純擬音:雨夜木造茶館,絲袖擦過桌面,三步皮靴靠近,木門滑開,最後瓷杯落在木桌上。不要對白和音樂。
雨夜茶館
0:12
為影視、廣告和在地化內容生成原創配樂、記憶點與背景音樂,不必再花時間翻找曲庫素材。
創作一段絲路夜行電影配樂:彈撥樂器、框鼓與現代低音結合,在第 8 秒進入清晰記憶點。純器樂,不要人聲。
絲路夜行
0:16
用明確的角色、情緒和母語級表達完成對白、廣告與旁白在地化,而不是機械的單聲線朗讀。
黎明前的港口,將同一段克制的雙人對白分別生成義大利語和中文版本。保持自然發音、輕微港口環境聲,不要音樂。
港口燈光 · 義大利語
0:14
讓已獲授權的角色聲線或品牌聲音在不同劇集、廣告和市場中保持一致,同時按需更換文案。
使用 @Audio1 作為已授權的聲音參考,保留溫暖的音色、從容語速和輕柔口音,朗讀:‘Every new chapter begins with one clear breath.’
授權原聲
靜謐時刻 · 原聲
0:09生成版本
新的篇章 · 複製
0:07Seed Audio 1.0 与传统 TTS 对比
传统 TTS 的核心任务是把文字转换成语音;Seed Audio 1.0 面向更完整的音频生成工作流,可在一个声音场景中统筹对白表演、环境声、音乐和音效。
| 对比维度 | Seed Audio 1.0 | 传统 TTS(如早期商业 TTS、基础语音合成) |
|---|---|---|
| 核心定位 | 全场景音频创作(Scene-level Audio Creation) | 纯文本转语音(Text-to-Speech) |
| 生成内容 | 人声对白 + 背景音乐 + 音效 + 环境声(一次生成并混音) | 仅人声(单一语音轨道) |
| 多角色对白 | 原生支持,单次生成多角色、情绪、节奏协调的对话 | 需多次调用不同音色,再人工对齐/混音 |
| 背景音乐 & 音效 | 支持,与对白同步生成,自动匹配情绪与时间线 | 不支持,需额外工具(音乐模型 + 音效库 + DAW) |
| 输入方式 | 文本提示词 / 参考音频(最多 3 段)/ 参考图片 | 主要是文本 + 预设音色(部分支持简单参考) |
| 语音克隆 | 零样本(Zero-shot),上传短参考音频即可(约 30 秒内) | 多数需要微调/训练,或依赖有限音色库 |
| 情绪与表现力控制 | 自然语言提示词直接描述情绪、语气、口音、节奏 | 主要靠 SSML 标签或有限参数,控制范围较窄 |
| 时间轴控制 | 支持精细时间戳控制对白出现时机 | 基本无此能力 |
| 输出形式 | 完整混好的音轨(非流式,最长约 2 分钟/次) | 单一语音文件,需后期拼接音乐与音效 |
| 适用场景 | 有声剧、短剧配音、广告、游戏音频、播客冷开场、视频旁白等需要完整声音场景的内容 | 有声书朗读、导航、客服、简单旁白等纯语音需求 |
| 工作流变化 | 一条提示词 → 成品音轨(大幅减少后期混音) | 语音生成 → 找音乐 → 找音效 → 手动对齐混音 |
如果只需要稳定、可预测的语音,传统 TTS 依然更简单;如果环境与声音设计也是成品的一部分,Seed Audio 1.0 更合适。
清晰流程
從聲音想法出發,用一條 Prompt 定義角色、情緒、地點、對白、音樂、環境與音效,形成完整的聲音場景方向。
從角色、情緒、地點、節奏、對白、音樂氛圍和需要出現的音效開始。
Seed Audio 1.0 面向對白、情緒語氣、原生口音、環境聲、BGM 與獨立音效的一體化合成。
為短片、廣告、播客、遊戲、學習內容等需要快速驗證完整聲景的專案提供聲音方向。
Seed Audio 1.0 技術方向
Seed Audio 1.0 面向完整音訊場景:多角色對白、情緒、語氣、口音、環境底聲、BGM 和擬音可以在一次創作流程中完成。
多說話人
長聲音場景中的音色連續性
文本 / 影像 / 音訊
面向音訊創作的多模態提示
不再把人聲、音樂、環境和音效拆到多個工具裡拼接,而是在一次生成裡編排多層聲音。
引導語氣、情緒表達、方言和原生口音,同時讓反覆出現的聲音在不同語境中保持可識別。
在對白旁同步生成環境底聲、背景音樂、房間聲、天氣、人群或遠處城市質感。
Seed Audio 1.0 面向更長的聲音場景,適合對白、環境聲和帶音樂的片段化內容生成。
創作可能性
當專案需要的不只是旁白,而是有角色、情緒、空間和事件的完整聲景時,Seed Audio 1.0 的價值最明顯。
為分鏡或預演草擬對白、情緒點、擬音、環境和音樂。
為產品演示、社媒短片和本地化廣告快速生成聲音方向。
在最終音訊製作前,原型化環境迴圈、角色語音、UI 聲和過場聲效。
用空間聲音線索構建情景課程、角色對話和沉浸式講解。
帶情緒語氣的多角色表達
雨聲、車流、房間、人群與自然底聲
腳步、撞擊、開門、質感與時機
價格
按需購買一次性積分包,適合測試、個人創作和更高用量的 AI 音訊生成。所有積分包都支援提示詞生成和可選參考素材。
查看 Seed Audio 1.0 完整價格註冊即可試用 Seed Audio 1.0,適合體驗提示詞與短場景生成。
適合有持續音訊生成需求的創作者,年付更划算。
適合預計高頻使用 AI 音訊生成的團隊,年付價效比最高。
常見問題
給想了解 Seed Audio 1.0 並用於 AI 音訊生成的創作者提供實用答案。